Table of Contents
개인 프로젝트로 만든 여행 챗봇에 골든셋을 처음 넣어봤다. 응답을 화면에 어떤 계약으로 넘기는지는 지난 글에 정리했다.
그 전에 만든 챗봇들에는 이 계층이 없었다. 테스트 자체가 없던 건 아니다. B2B 챗봇에서는 RAG 검색 툴이 documents·queries·topK를 제대로 돌려주는지, 벡터DB가 503을 낼 때는 재시도하고 4xx에는 재시도하지 않는지, 딜러 위치 리졸버가 맞는 지점을 찾는지를 JUnit으로 커버했다. 이력서 어시스턴트는 파일 변환과 플러그인을 pytest로, 생활 관리 어시스턴트는 API와 스케줄러를 Testcontainers 통합 테스트로 확인했다.
빠져 있던 건 LLM이 판단하는 부분이었다. 그 영역은 문서에 발화를 모아 두고 손으로 넣어보며 눈으로 확인했다. 생활 관리 어시스턴트에는 test_messages.md라는 파일이 있고 거기에 이런 목록이 카테고리별로 정리돼 있다.
### 3.1 건강 기록 (MEAL_LOG)
토스트 먹었어
아침에 샐러드 먹었어
점심으로 김치찌개 먹었어
입력은 정리돼 있지만 그 응답이 무엇을 충족해야 하는지, 통과인지 아닌지를 누가 정하는지는 문서 밖에 있었다. 개발하면서 매번 직접 넣어보고 확인하는 것으로 그 자리를 메웠다. 이번에는 그 판정을 코드로 옮겨보고 싶었다.
정답 문장 대신 조건을 적었다
이 프로젝트에서는 골든셋에 대표 입력과 응답이 충족해야 할 조건을 짝지어 적었다. 정답 문장을 하나 정해 두고 비교하는 대신 응답이 지켜야 할 조건을 적는다.
“제주도 갈까 하는데”라는 발화에 에이전트가 뭐라고 답할지는 매번 다르다. 하지만 일정 카드를 바로 내밀면 안 되고 기간이나 인원을 되물어야 한다는 건 매번 같아야 한다. 문장이 아니라 이 조건을 적어두는 방식이다.
판단과 실행을 나눴다
에이전트라고 전부 비결정적인 건 아니었다. 코드를 뜯어보니 두 종류가 섞여 있었다.
- 판단: “저녁 비행기로 제일 싼 거”라는 발화에서 시간대와 정렬을 정한다. LLM이 한다.
- 실행: 날짜 계산, 박수 배분, 총액 합산, 결제·FAQ 게이트. 코드가 한다.
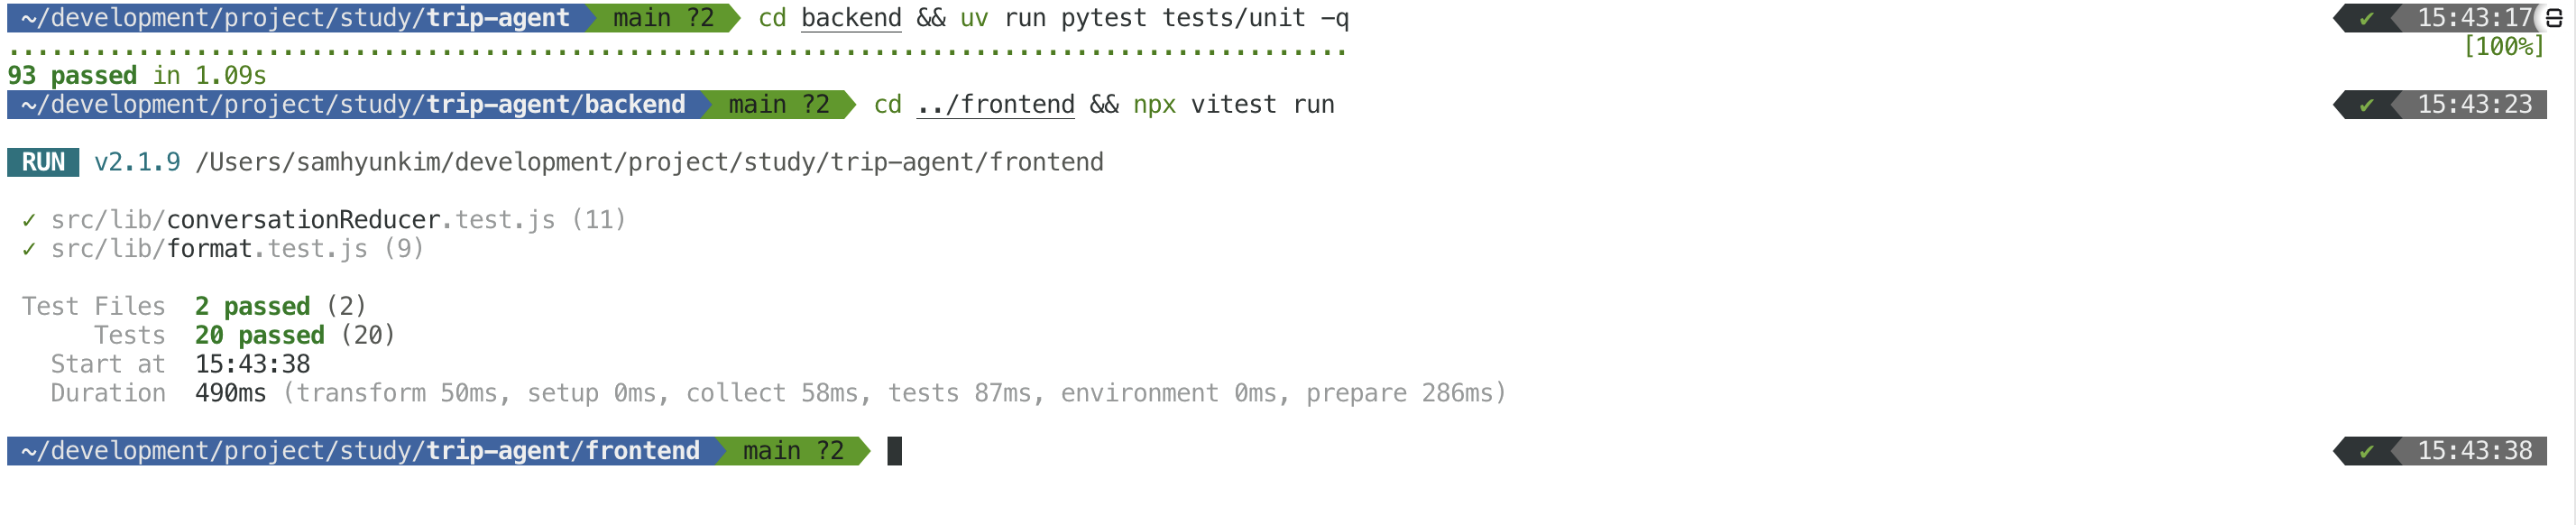
실행 쪽은 이미 순수 함수로 분리돼 있어서 mock 없이 오프라인 유닛 테스트가 바로 됐다. 날짜 라벨이 하루씩 밀리는지, 두 도시에 숙박을 나눌 때 박수 합이 맞는지, 총액에 음수나 bool이 들어와도 버티는지 같은 것들이다. 글을 쓸 당시 파라미터라이즈까지 펼치면 백엔드에서 93개가 수집됐고 프론트의 합계·박수 파싱은 vitest 20개로 확인했다.
골든셋은 나머지, 그러니까 LLM이 판단하는 자리에만 쓴다. 실행까지 골든셋으로 커버하면 LLM을 부르는 느린 테스트가 늘어날 뿐이다.
여기에 골든셋보다 먼저 있던 라이브 E2E를 더하면 계층이 셋이 된다. E2E는 실제 서버를 띄우고 HTTP 요청으로 시나리오를 훑는 스크립트다. provider 키가 있으면 실 API를 먼저 호출하지만 키가 없거나 호출이 실패하면 mock으로 폴백한다. 그래서 전체 통합 흐름은 볼 수 있어도 응답이 실 provider에서 왔다는 것까지 보증하지는 않는다. 응답 표현이 바뀌면 문자열 단언이 흔들리는 문제도 있다.
| 계층 | 무엇을 커버하나 | 실행 조건 | 규모 |
|---|---|---|---|
| 유닛 | 코드가 하는 실행(날짜·박수·총액·게이트) | 오프라인, mock 불필요 | 작성 당시 백엔드 93개 + 프론트 20개 |
| 골든셋 | LLM이 하는 판단 | 실 LLM 호출 | 10케이스, 구조 단언 + judge |
| 라이브 E2E | HTTP API부터 카드 응답까지의 통합 흐름 | 실행 중인 서버, 실 API 확인 시 각 키 | 체크 32개 |
유닛 계층은 이 정도 속도로 돈다. 백엔드와 프론트 모두 LLM을 부르지 않아 합쳐도 2초가 안 걸린다.
케이스는 다섯 필드로 적는다
케이스 파일(cases.py)에 딕셔너리를 나열한다. 하나는 이렇게 생겼다.
{
    "id": "ask-back-vague",
    "messages": ["제주도 갈까 하는데"],
    "expect": {
        "no_card": ["itinerary", "flight_results", "hotel_results", "destination_carousel"],
    },
    "rubric": (
        "사용자가 목적지만 말하고 기간·인원은 말하지 않았다. "
        "봇이 명소나 일정을 바로 제시하지 않고, 기간이나 인원을 되물어야 한다."
    ),
    "requires": [],
}id: 실행 결과에 찍히는 이름.--filter로 골라 돌릴 때도 쓴다.messages: 사용자 발화. 여러 개면 멀티턴이라 순서대로 실행한다.expect: 기계가 그대로 검사할 구조 단언.rubric: LLM judge가 읽을 판정 기준. 비워 두면 judge를 건너뛴다.requires: 이 케이스에 필요한 외부 API 키. 없으면 실패가 아니라 스킵으로 뺀다.
requires를 따로 둔 이유는 실패의 성격이 다르기 때문이다. 해외 항공·숙소 provider 키가 없어서 못 도는 것은 제품이 망가진 게 아니라 환경이 덜 갖춰진 것이다. 이걸 실패로 세면 회귀 신호가 오염된다. 다만 requires가 확인하는 것도 키의 유무까지다. provider가 실제로 응답했는지는 별도 단언이 없으면 알 수 없다.
검증은 두 계층으로 나눴다
구조 단언은 코드로 검사한다
카드 타입 유무나 특정 문구 포함 여부처럼 계약으로 정해진 것은 코드로 확인한다. 1편에서 렌더 계약으로 정한 type이 여기서는 has_card와 no_card의 검사 기준이 된다. 검사 방식은 늘 같지만 응답 구조까지 항상 같다는 뜻은 아니다. 어떤 노드로 갈지는 LLM의 판단에 따라 달라질 수 있다. 러너가 해석하는 단언은 여섯 가지다.
| 키 | 검사 |
|---|---|
has_card | 이 카드 타입이 응답에 있어야 한다 |
any_card | 나열한 것 중 최소 하나는 있어야 한다 |
no_card | 이 타입이 나오면 안 된다 |
contains | 응답 텍스트에 이 문구가 있어야 한다 |
not_contains | 이 문구가 나오면 안 된다 |
final_agent | 마지막 응답을 낸 노드가 이것이어야 한다 |
의미는 LLM judge에게 맡긴다
일정 문장이나 되묻기, FAQ 답변의 품질은 문자열로 잡히지 않는다. 그래서 별도 LLM에게 rubric을 주고 PASS/FAIL 판정과 한 줄 사유를 받는다.
_JUDGE_SYS = (
    "너는 여행 챗봇의 응답을 평가하는 엄격한 심사자다. "
    "아래 [기준]을 응답이 충족하면 PASS, 아니면 FAIL로만 판정한다. "
    "반드시 첫 줄에 PASS 또는 FAIL 한 단어만 쓰고, 다음 줄에 한 줄 사유를 쓴다."
)
프롬프트는 첫 줄에 PASS나 FAIL만 쓰도록 요구한다. 러너는 응답이 PASS로 시작하는지 보고 통과 여부를 정한 뒤 나머지를 사유로 출력한다.
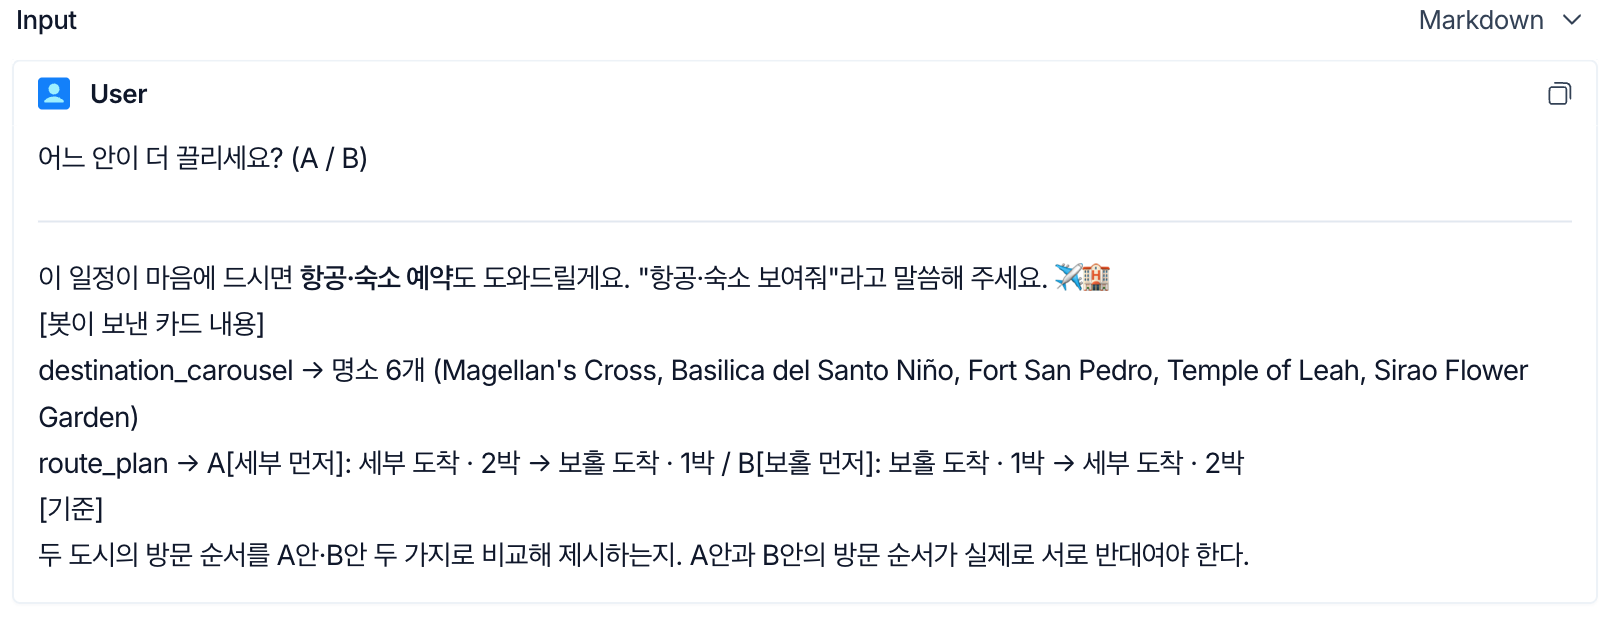
judge에게 무엇을 보여줄지도 정해야 했다. 응답 텍스트만 넘기면 카드 안에 뭐가 들었는지 judge가 볼 수 없다. 이 프로젝트는 카드의 실체가 payload에 있어서 텍스트만으로는 “동선 A안과 B안을 둘 다 제시했는가” 같은 기준을 판정할 수 없다. 그래서 카드를 한 줄로 요약해 함께 넘긴다.
if typ == "hotel_results":
    names = ", ".join(h.get("name", "") for h in p.get("hotels", [])[:4])
    return f"hotel_results → 숙소 {len(p.get('hotels', []))}곳 ({names})"
judge에게 가는 프롬프트는 사용자 발화, 봇 응답 텍스트, 카드 요약, 기준의 네 블록으로 조립된다. 조립된 결과는 LangSmith에서 그대로 열어볼 수 있다. LangSmith는 에이전트가 거친 노드와 각 호출에 들어간 프롬프트, 토큰 사용량과 실행 시간을 기록한다.
이 프로젝트는 LANGSMITH_TRACING=true와 API key를 설정해 LangGraph 실행을 기록했다. 러너를 돌리자 골든셋 실행도 함께 쌓였다. 아래는 실제로 judge에게 보낸 프롬프트다. 텍스트만 넘겼다면 judge는 A안·B안이 카드 안에 들어 있는지 알 수 없었다.
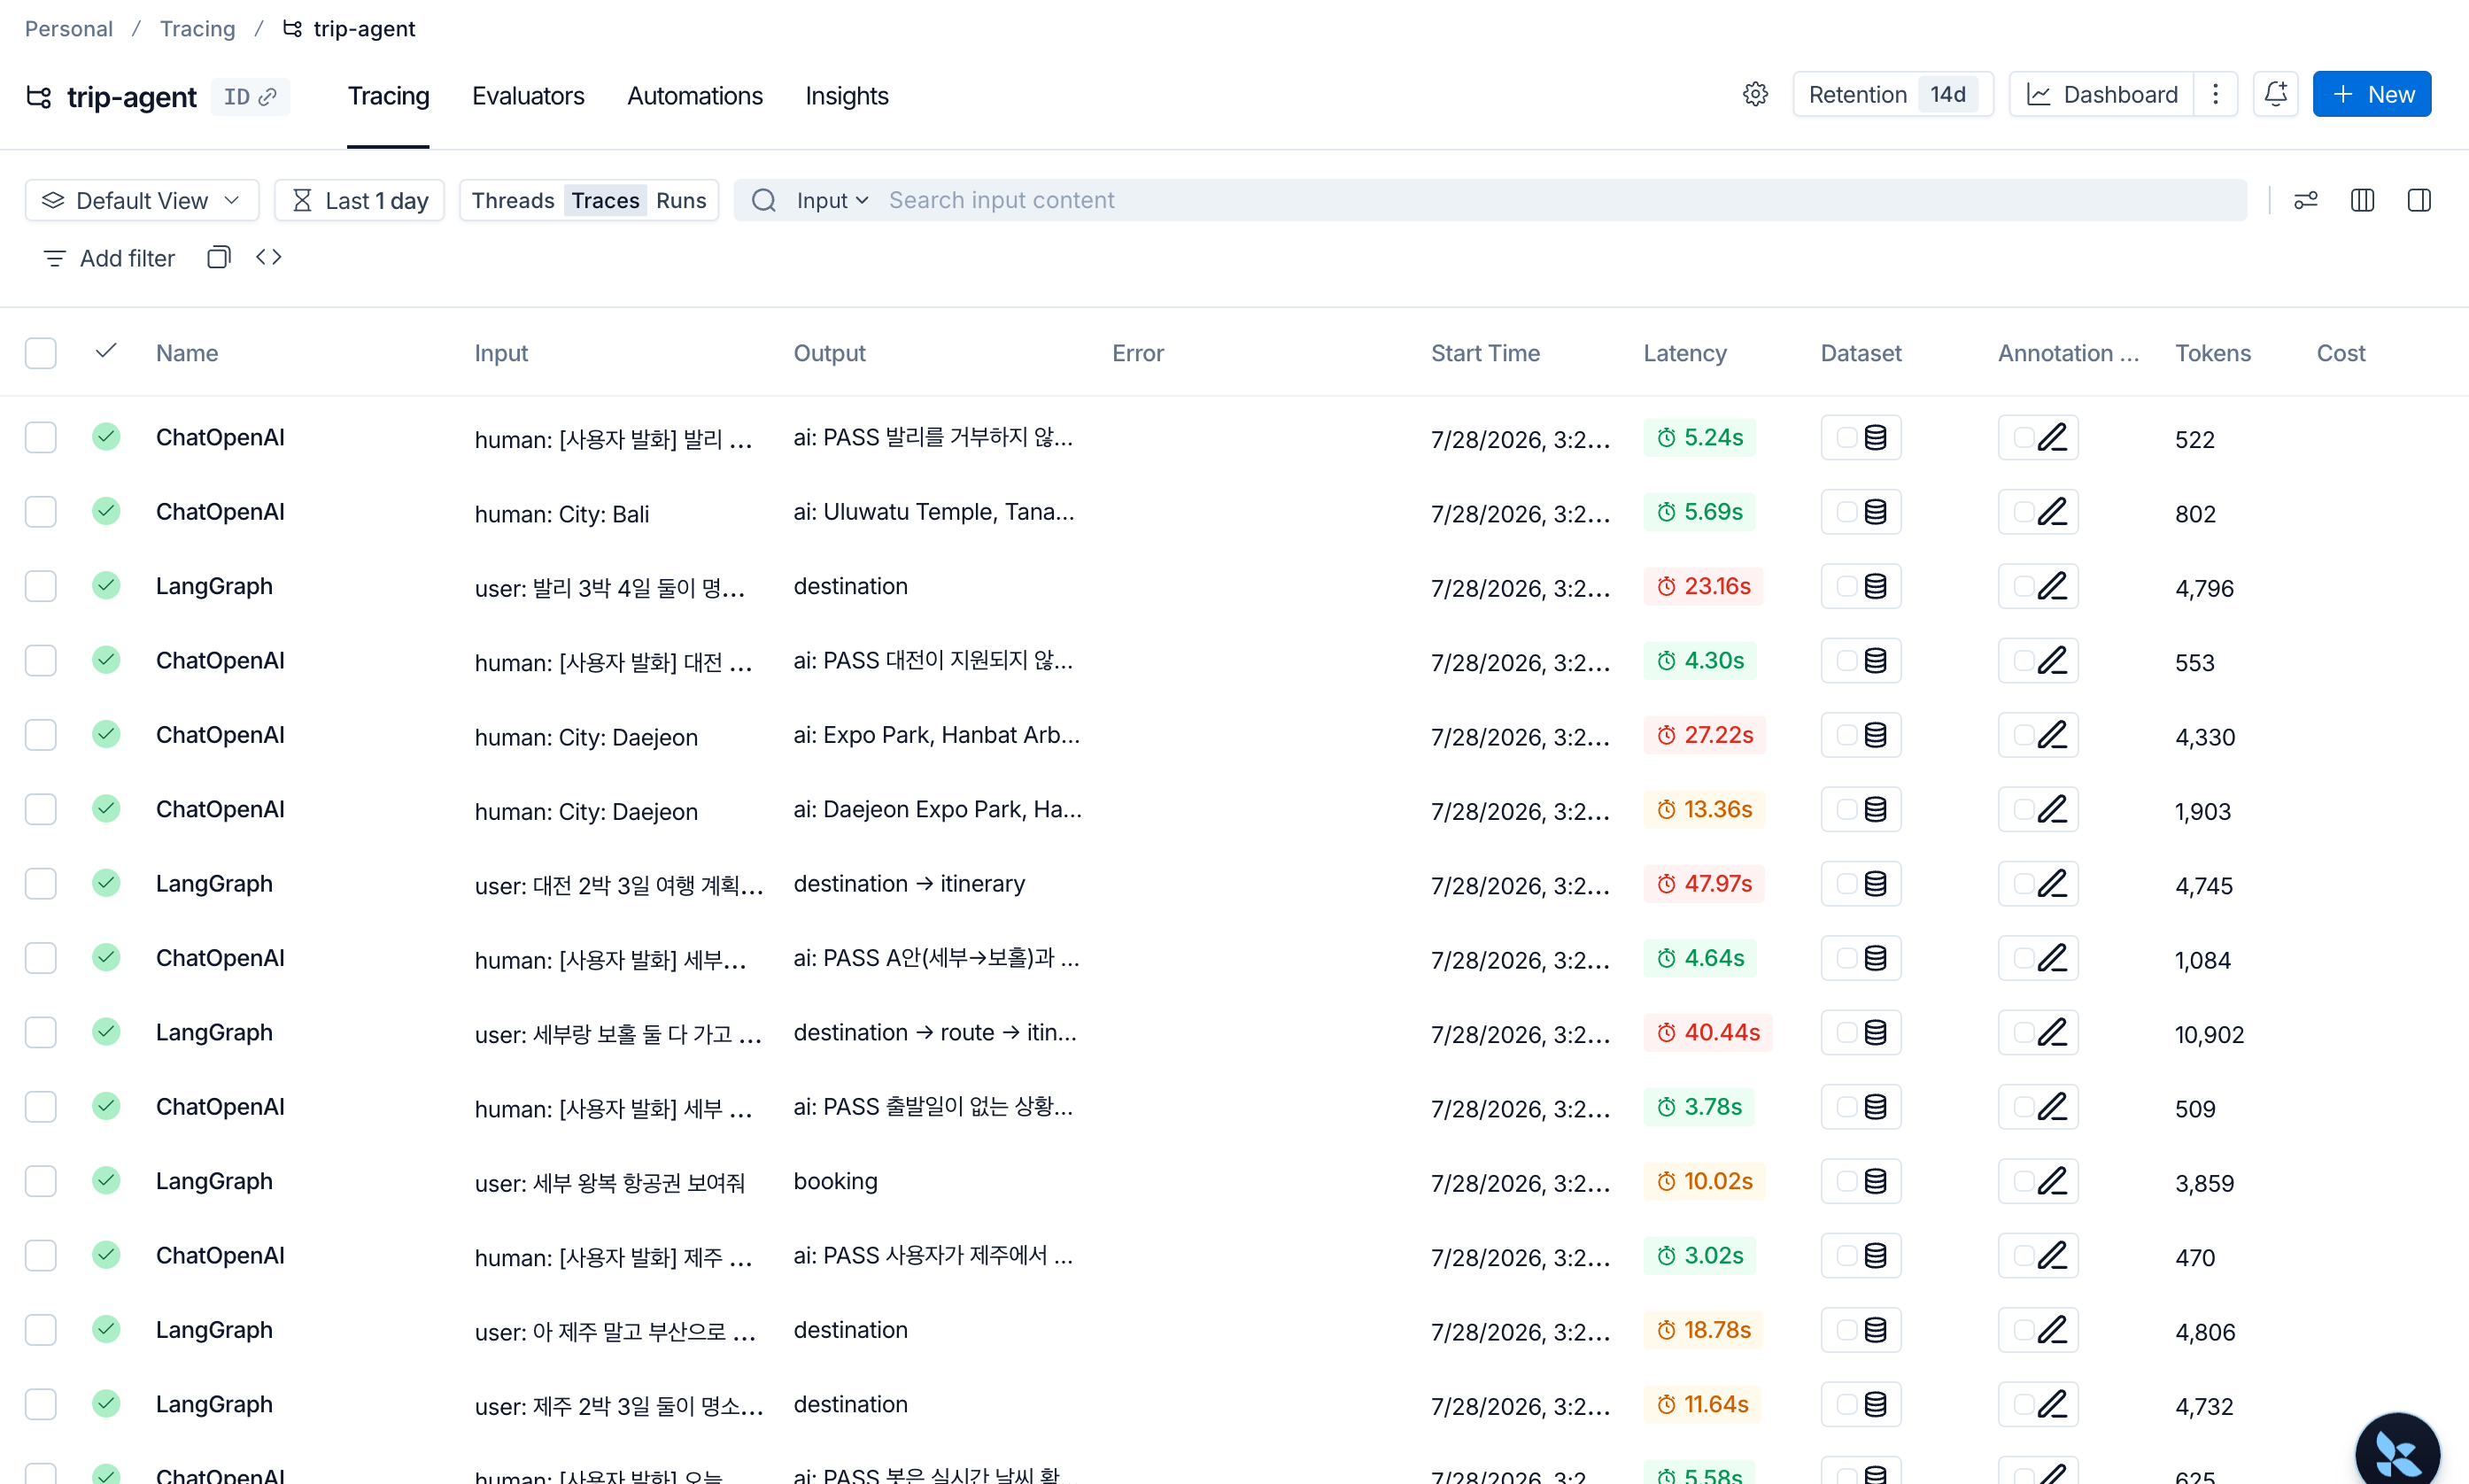
트레이스를 열어 보면 judge가 에이전트와 별개의 호출이라는 게 그대로 보인다. LangGraph로 잡힌 줄이 에이전트 한 턴이고 출력에 destination → route → itinerary처럼 거쳐 간 노드가 찍힌다. 그 사이에 섞인 ChatOpenAI 줄 중에서 입력이 [사용자 발화]로 시작하고 출력이 PASS로 시작하는 것이 judge다. 나머지 ChatOpenAI 줄은 에이전트가 명소를 뽑으려고 내부에서 부른 호출이다. judge는 토큰이 500 안팎이라 4,000에서 10,000을 쓰는 에이전트 한 턴보다 한참 가볍다.
비결정성은 통과율로 다룬다
한 번 돌려서 통과했다고 안심할 수 없고 한 번 실패했다고 그게 회귀인지 그날의 흔들림인지 알기 어렵다. 그래서 케이스마다 여러 번 돌려 몇 번 중 몇 번 통과했는지를 남긴다.
uv run python tests/golden/run.py                 # 1회씩
uv run python tests/golden/run.py --repeat 3      # 각 3회, 통과율 판정
uv run python tests/golden/run.py --filter faq    # id에 faq 포함만
uv run python tests/golden/run.py --no-judge      # judge 호출 없이 구조 단언만
그 통과율을 어디서 끊을지는 --threshold가 정한다. 기본값이 1.0이라 지금은 반복한 회차를 전부 통과해야 넘어가고 한 번이라도 걸리면 실패로 본다. 흔들림을 어디까지 허용할지 아직 정하지 못해 일단 가장 엄격한 값에 두었다. --no-judge도 에이전트 LLM은 그대로 호출하고 judge 호출만 생략한다. 전체 실행이 무료인 것은 아니지만 케이스마다 추가되던 judge 호출 비용과 시간을 줄일 수 있다.
출력은 케이스별로 한 줄씩 찍힌다. 키를 다 넣고 judge까지 켜서 한 번 돌리면 이렇게 나온다. 열 개를 한 번씩만 돌렸는데 5분 18초가 걸렸다.
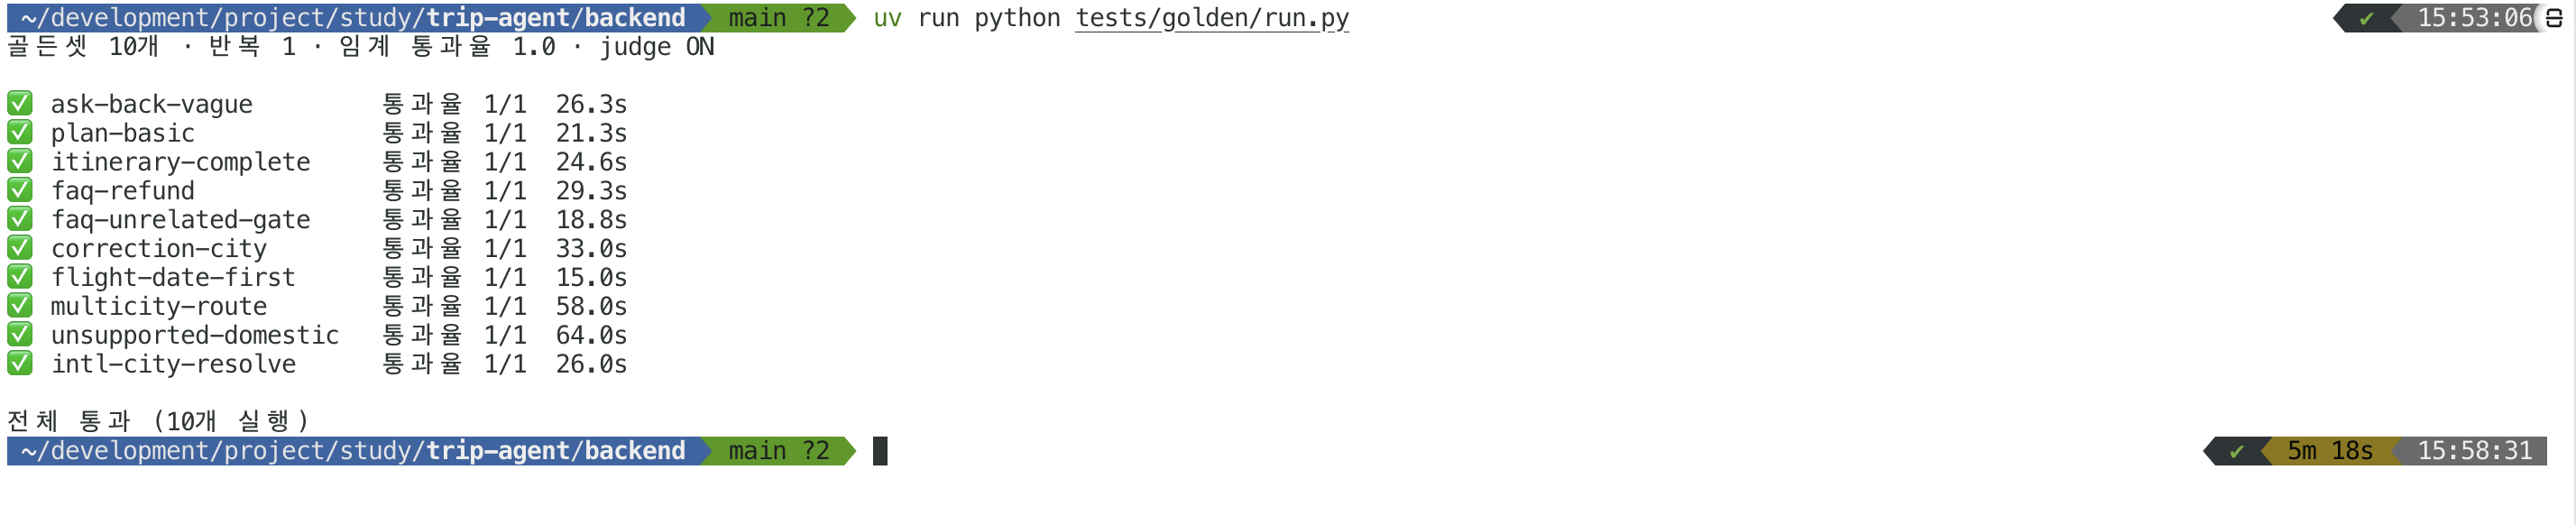
이 시간의 대부분은 러너가 아니라 에이전트가 쓴다. 케이스마다 15초에서 64초까지 벌어지는 것도 거쳐 가는 노드 수가 달라서다. 항공권만 찾는 케이스는 booking 노드 하나로 끝나 10초대에 돌아온다. 두 도시 동선을 짜는 케이스는 명소를 고르고 동선을 잡고 일정까지 채우느라 노드를 셋 지나며 40초를 쓴다. 그 안에서 시간을 먹는 건 외부 여행 API의 응답을 기다리는 시간과 LLM이 답을 만드는 시간이다. judge는 여기에 몇 초를 더한다. 골든셋이라서 느리다기보다 에이전트 한 턴이 원래 이만큼 걸린다.
임계 통과율에 못 미치면 케이스 줄 밑에 사유가 붙는다. 위에서 통과했던 ask-back-vague가 다음 회차에 걸렸을 때는 이렇게 찍혔다.
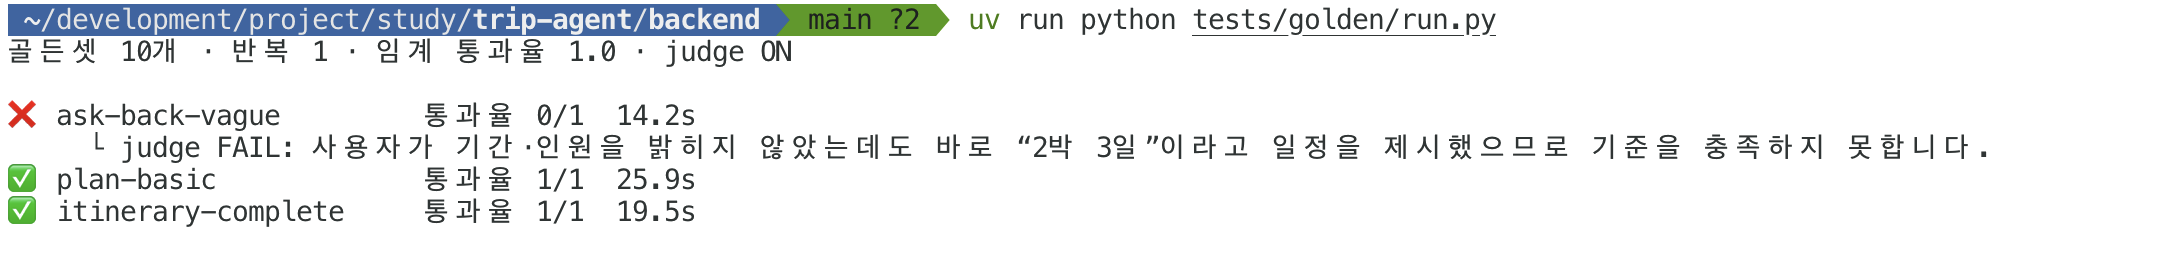
기간과 인원을 되묻지 않고 바로 “2박 3일” 일정을 냈다는 판정이다. 코드는 그대로인데 회차에 따라 결과가 갈렸다. --repeat와 통과율을 둔 이유가 여기에 있다. 필요한 키가 없는 케이스는 이 자리에 ⏭️로 찍히고 실행 자체를 건너뛴다.
종료코드는 셋으로 나눴다. 전부 통과면 0, 임계 미달이 하나라도 있으면 1, 인자가 잘못됐거나 LLM 키가 없으면 2다. LLM이 설정되지 않은 채로 돌리면 에이전트가 mock으로만 답해서 골든셋이 의미가 없다. 이 경우는 통과도 실패도 아니라고 보고 2로 빠져나온다. 아직 CI에 걸어 두진 않았지만 게이트로 쓸 수 있는 형태는 갖췄다.
써보니
케이스를 적는 일이 생각보다 많은 걸 정리해줬다. test_messages.md에 발화만 적어둘 때는 “이 발화를 넣으면 대충 이렇게 나오면 된다”가 머릿속에만 있었다. expect와 rubric을 쓰려면 그 기대를 문장으로 확정해야 한다. 그 과정에서 내가 기대한 동작과 실제 설계가 다른 자리도 몇 군데 드러났다.
처음 열 개를 돌렸을 때 셋이 실패했다. 두 개는 기대 조건을 잘못 적은 케이스였고 하나는 러너가 payload를 judge에게 넘기지 않은 문제였다.
미지원 도시. “대전 2박 3일 여행 계획 짜줘”에 일정 카드가 없어야 한다고 적었다. 실제로는 itinerary 노드가 “지원하지 않는 여행지”라는 안내를 itinerary 타입 카드로 낸다. 가짜 일정을 지어낸 게 아니라 거절을 카드에 담은 것이라 카드 유무로 보는 단언 자체가 이 케이스에 맞지 않았다. 카드가 나오느냐가 아니라 내용이 거절이냐를 rubric으로 보도록 바꿨다.
항공권 되묻기. “세부 왕복 항공권 보여줘”에 항공 카드가 바로 나온다고 적었다. 하지만 날짜가 없으면 출발일부터 되묻는 것이 이 프로젝트가 정해 둔 흐름이었다. 케이스 id를 flight-date-first로 두고 기대를 되묻기로 바꿨다.
동선 A/B. 카드는 나왔는데 judge가 B안이 없다고 FAIL을 냈다. payload에는 A안과 B안이 제대로 들어 있었다. judge에게 텍스트와 카드 타입만 넘기고 payload를 안 넘긴 게 원인이었다. 카드 요약을 함께 넘기도록 러너를 고쳤고 위에 적은 _card_digest가 이때 생겼다.
골든셋이 제품 회귀를 잡기 전에 내가 적은 기대부터 검사한 셈이다. 처음 도입할 때는 이 단계가 꽤 길다는 것도 같이 알았다.
번거로운 점도 있다. 골든셋은 실 LLM을 호출하니 돌릴 때마다 비용과 시간이 든다. judge를 켜면 케이스당 호출이 하나 더 붙는다. 유닛 113개는 2초면 끝나는데 골든셋은 열 개를 한 번 도는 데 5분이 넘고 --repeat 3이면 15분을 넘긴다. 그래서 커밋마다 돌리는 대신 프롬프트나 노드 흐름을 건드렸을 때 돌리는 쪽으로 굳어졌다.
놓치는 쪽과 잘못 잡는 쪽
회귀를 양성으로 보면 회귀를 놓칠수록 재현율이 낮아지고 정상 응답을 회귀로 잡을수록 정밀도가 낮아진다. 골든셋에서도 두 방향을 함께 봐야 했다.
무엇을 놓칠지는 먼저 케이스 목록이 정한다. 지금 열 개는 명소·일정·항공·숙소·FAQ·미지원 도시를 커버하지만 결제와 예약 확정 흐름은 유닛에만 남아 있다. 그 경로에서 판단이 달라져도 골든셋은 아무 말을 하지 않는다. 케이스를 늘리면 이쪽이 줄어드는 대신 실행 시간과 비용이 그만큼 붙는다. 열 개를 한 번 도는 데 이미 5분이 넘으니 늘리는 속도에도 한계가 있다.
반대로 정상 응답을 실패로 잡는 판정은 기대 조건을 잘못 적거나 rubric이 모호할 때 생길 수 있다. faq-refund에서도 같은 질문의 판정이 회차에 따라 갈렸다.
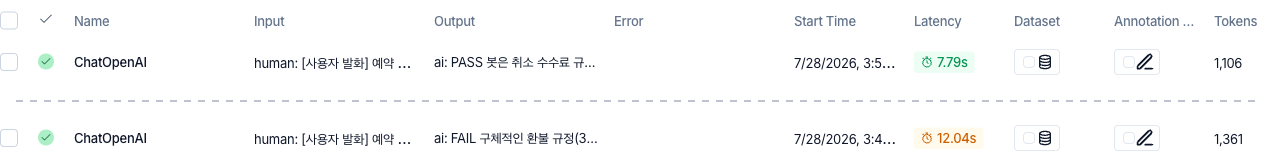
봇 답변은 두 번 다 환불 규정을 제시하고 하단에 참고 FAQ를 표기했다. 그런데 FAIL을 낸 judge는 “그 수수료 규정이 명시된 등록 FAQ 항목(또는 링크)을 명확히 근거로 제시하지 않아 규정을 임의로 기재했을 가능성이 있다”고 적었다. 현재 러너는 에이전트와 judge를 함께 다시 실행하므로 이 결과만으로 어느 쪽이 달라졌는지는 분리할 수 없다. 다만 실패 사유를 보면 rubric이 요구한 출처 표기의 범위가 모호했다.
rubric에는 “출처가 표기돼야 한다”고만 적어뒀다. 표기의 형태를 정하지 않으니 어떤 회차에는 인용이나 링크까지 요구했다. 이런 건 judge에게 맡길 게 아니라 “참고 FAQ라는 라벨을 붙인다”를 계약으로 정해 두고 contains: ["참고 FAQ"]로 검사할 조건이었다. 라벨이 붙었는지만 보는 단언이라 출처의 내용까지 보증하지는 못하지만 적어도 회차마다 기준이 달라지지는 않는다. 무엇을 코드로 검사하고 무엇을 judge에게 넘길지 케이스마다 다시 봐야 할 것 같다.
케이스 목록과 --threshold는 다른 축이다. 케이스 목록은 무엇을 검사할지 정한다. --threshold는 같은 케이스를 반복했을 때 몇 번의 실패까지 허용할지 정할 뿐이다. 기본값 1.0은 한 번의 흔들림도 실패로 세고 값을 낮추면 간헐적으로 나타나는 회귀를 통과시킬 여지가 생긴다. 어느 쪽 실수를 더 감당할지는 케이스가 쌓여봐야 감이 올 것 같다.
남은 것
judge가 LLM이라는 점은 남는다. --repeat는 케이스 실행을 통째로 반복하기 때문에 통과율 2/3이 나왔을 때 에이전트와 judge 중 어느 쪽이 달라졌는지 구분되지 않는다. 둘을 나눠 보려면 에이전트의 응답을 고정한 뒤 judge만 반복해서 실행하는 경로가 필요하다. 지금 규모에서는 실패 사유를 직접 읽어보고 있다.
FAQ가 늘어나면 Ragas 같은 RAG 평가 도구도 검토할 수 있다. Faithfulness는 답변의 주장이 검색 근거로 뒷받침되는지 본다. Context Recall은 필요한 근거를 얼마나 놓치지 않았는지, Context Precision은 유용한 문서가 앞에 배치됐는지를 본다. 다만 지표마다 필요한 데이터와 평가 방식이 다르다. 정답이나 기준 문맥이 필요한 것도 있고 LLM을 쓰지 않는 방식도 있다. 현재의 참고 FAQ 라벨 검사는 검색 품질 평가와는 별개라 구조 단언으로 남겼다. FAQ가 늘어나 검색 품질 자체를 따져야 하는 시점이 오면 그때 다시 볼 생각이다.
참고
- LangSmith
- LangGraph Documentation
- Ragas
- pytest — How to parametrize fixtures and test functions
- Vitest
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
여행 챗봇 시리즈
- #llm
- #testing
- #agent
- #golden-set
- #langgraph