Table of Contents
개인 프로젝트로 만든 여행 챗봇의 주요 기능을 마무리하고 데모를 녹화하던 중 응답이 멈췄다. 로그를 보니 LLM 엔드포인트가 과부하로 504를 내고 있었다. 외부에 기대는 부분은 언제든 이렇게 멈출 수 있다. 그런데 정작 준비된 게 없었다. 안에서 무슨 일이 일어나는지 볼 수단도, 외부가 멈췄을 때 빠르게 물러설 장치도, 같은 작업을 매번 새로 처리하지 않을 방법도 없었다.
이 글은 그 셋을 어떻게 붙였는지 정리한 것이다. 렌더 계약은 1편에, 테스트는 2편에 적었다.
트레이싱을 켜는 한 줄의 자리
2편에서 골든셋 실행을 들여다볼 때 LangSmith를 썼다. 켜는 방법 자체는 간단하다. LANGSMITH_TRACING=true와 API key를 환경변수에 넣으면 LangChain·LangGraph 실행과 그 안의 LLM 호출이 자동으로 기록된다. 별도 계측 코드를 넣을 필요는 없다.
그런데 .env에 키를 넣어도 트레이싱이 켜지지 않았다. 원인은 설정을 읽는 경로가 둘이라는 데 있었다. 이 프로젝트는 .env를 pydantic-settings로 읽는데 그건 값을 Settings 객체 안에만 담고 os.environ에는 올리지 않는다. 반면 LangSmith SDK는 os.environ을 직접 본다. 앱 입장에서는 키가 있지만 SDK 입장에서는 없는 상태였다.
.env를 os.environ으로도 올리는 한 줄을 넣어 해결했다. 중요한 건 그 줄의 위치다.
from pathlib import Path

from dotenv import load_dotenv

# 루트 .env → os.environ. app.* import보다 먼저 실행해야
# 라이브러리(LangSmith 등)가 초기화 전 변수를 본다. (pydantic Settings는 env_file로 별개 로드)
load_dotenv(Path(__file__).resolve().parents[2] / ".env")

from fastapi import FastAPI, Request # noqa: E402app.*을 import하는 과정에서 LangChain 객체와 tracer가 초기화될 수 있다. 그래서 load_dotenv가 다른 앱 import보다 앞에 오도록 했다. 파일 상단에 import를 모아야 한다는 린트 규칙과 부딪히니 뒤따르는 import마다 # noqa: E402를 달아 순서를 지켰다.
켜고 나니 요청 하나가 어느 노드에서 얼마나 걸렸는지, 프롬프트에 실제로 무엇이 들어갔는지가 타임라인으로 보였다. 2편에서 골든셋 케이스마다 15초에서 64초까지 벌어진 이유를 짚을 수 있었던 것도 이 트레이스 덕분이다. LLM 호출은 하위 trace로 시간이 따로 보였다. 여행 API 호출은 별도 trace가 없어서 해당 노드의 전체 시간과 LLM 시간을 대조해 대기 시간을 짐작했다.
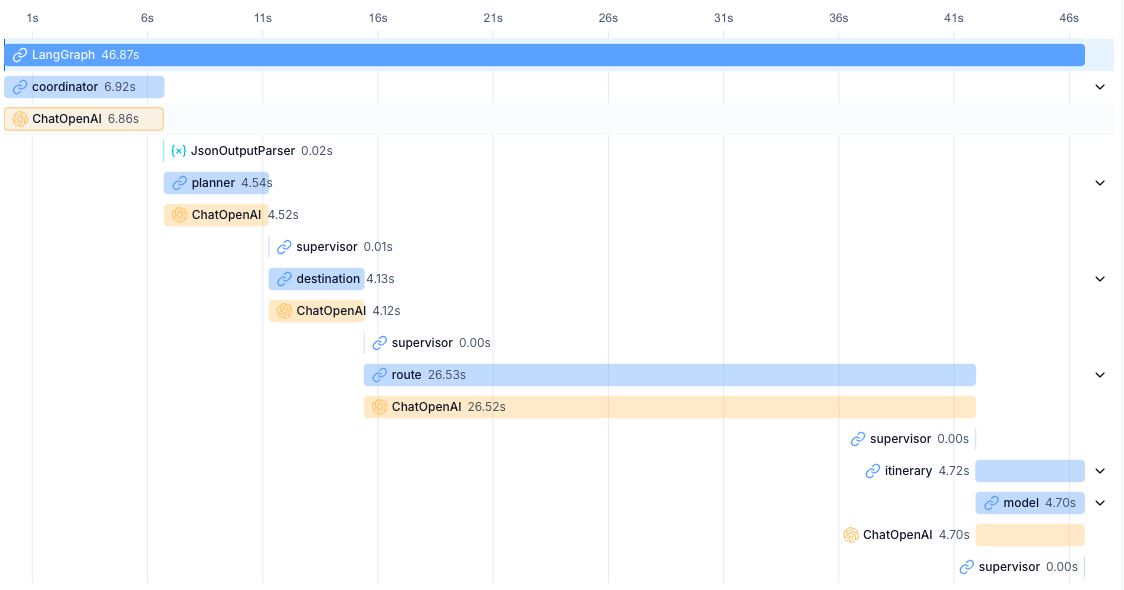
이 요청은 46.87초가 걸렸는데 그중 route 노드가 26.53초를 썼다. 막대 길이로 어디서 시간이 갔는지 바로 보인다. 노드 아래에 붙은 ChatOpenAI 막대가 그 노드의 LLM 호출이고, 노드 막대와 길이가 거의 같으면 그 시간은 대부분 LLM이 쓴 것이다.
대신 프롬프트와 응답이 외부 SaaS로 나간다. 개인 프로젝트라 그대로 켜 뒀지만 다루는 데이터에 따라 따져볼 부분이다. 입력과 출력을 숨기거나 민감한 값만 가리는 기능도 있지만 어떤 데이터를 보낼지 먼저 정해야 한다.
입출력을 통째로 숨기는 방법부터 정규식으로 특정 값만 가리는 방법까지 있다. 트레이싱을 켜기 전에 무엇을 보낼지 정해두는 편이 낫다.
provider마다 서킷브레이커를 달았다
504를 겪고 나서 provider 호출을 다시 봤다. 명소와 숙소는 등록된 provider를 우선순위대로 시도하다 모두 실패하면 mock으로 떨어진다. 항공은 Duffel 하나만 호출한다. 호출 구조는 다르지만 provider가 계속 죽어 있을 때 매 요청마다 같은 타임아웃을 기다리는 문제는 같았다.
처음 마주친 504는 LLM 엔드포인트에서 났지만 이번에 만든 서킷브레이커의 범위는 여행 데이터 provider다. LLM 팩토리의 폴백은 설정이 없을 때 다른 엔드포인트를 고르는 방식이라 실행 중 발생한 504에는 대응하지 않는다. LLM 호출의 재시도나 런타임 폴백은 별도로 남아 있다.
그래서 provider 이름별로 상태를 들고 있는 서킷브레이커를 공통 호출 함수로 만들었다. 명소·숙소의 폴백 루프와 항공의 단일 provider 호출이 모두 이 함수를 거친다.
_breaker = CircuitBreaker(threshold=3, cooldown=60.0)연속 3회 실패하면 그 provider를 60초 동안 건너뛰고 60초가 지나면 시험 호출 하나로 살아났는지 확인한다.
provider 호출을 공통 함수로 묶기
def call_with_breaker[T](name: str, fetch: Callable[[], T], context: str = "") -> T | None:
    if not _breaker.allow(name):
        logger.info("provider %s 차단됨(circuit) → 다음으로", name)
        return None
    try:
        result = fetch()
    except ProviderUnavailable as exc:
        logger.warning("provider %s fetch 실패: %s", name, redact(exc))
        _breaker.record_failure(name)
        return None
    except Exception:
        logger.exception("provider %s 예상하지 못한 오류", name)
        return None
    _breaker.record_success(name)
    return result
명소와 숙소는 차단된 provider를 건너뛰고 다음 후보를 시도한다. 항공은 provider가 하나라 차단되거나 실패하면 mock으로 내려간다. 어느 쪽이든 죽어 있는 provider의 타임아웃을 매번 기다리지 않는다.
빈 결과와 장애를 구분한다
여기서 한 가지를 신경 썼다. provider가 응답은 정상으로 했는데 그 도시 데이터가 없는 경우와 provider 자체가 죽은 경우는 다르다. 앞은 미커버고 뒤가 장애다. 외부 장애를 나타내는 ProviderUnavailable만 실패로 세고 응답이 오면 빈 결과여도 record_success를 부른다. 예상하지 못한 구현 오류는 스택을 로그로 남기되 서킷에는 세지 않고 다음 provider나 mock으로 넘어간다.
이 구분은 provider 쪽에서도 지켜야 한다. 처음에는 핵심 조회의 HTTP 실패를 각 provider가 None이나 빈 목록으로 돌려주고 있었다. Duffel도 장애와 항공편이 없는 경우를 모두 빈 목록으로 처리했다. 이 상태에서는 타임아웃이 나도 공통 호출 함수가 정상 응답으로 읽어 서킷이 열리지 않는다. 그래서 카드 생성에 필요한 핵심 조회는 장애일 때 ProviderUnavailable을 올리고 정상 응답에 결과가 없을 때만 None이나 빈 목록을 반환하도록 바꿨다.
사진·상세·요금처럼 카드 일부를 채우는 부가 조회는 실패해도 남은 데이터로 응답할 수 있어 기존 폴백을 유지했다. 명소 키워드를 여러 개 조회하는 자리도 일부 실패는 흡수하고 지역 기반 목록으로 부족분을 채운다. provider 전체가 죽었다면 이 백필 호출에서도 장애가 올라간다.
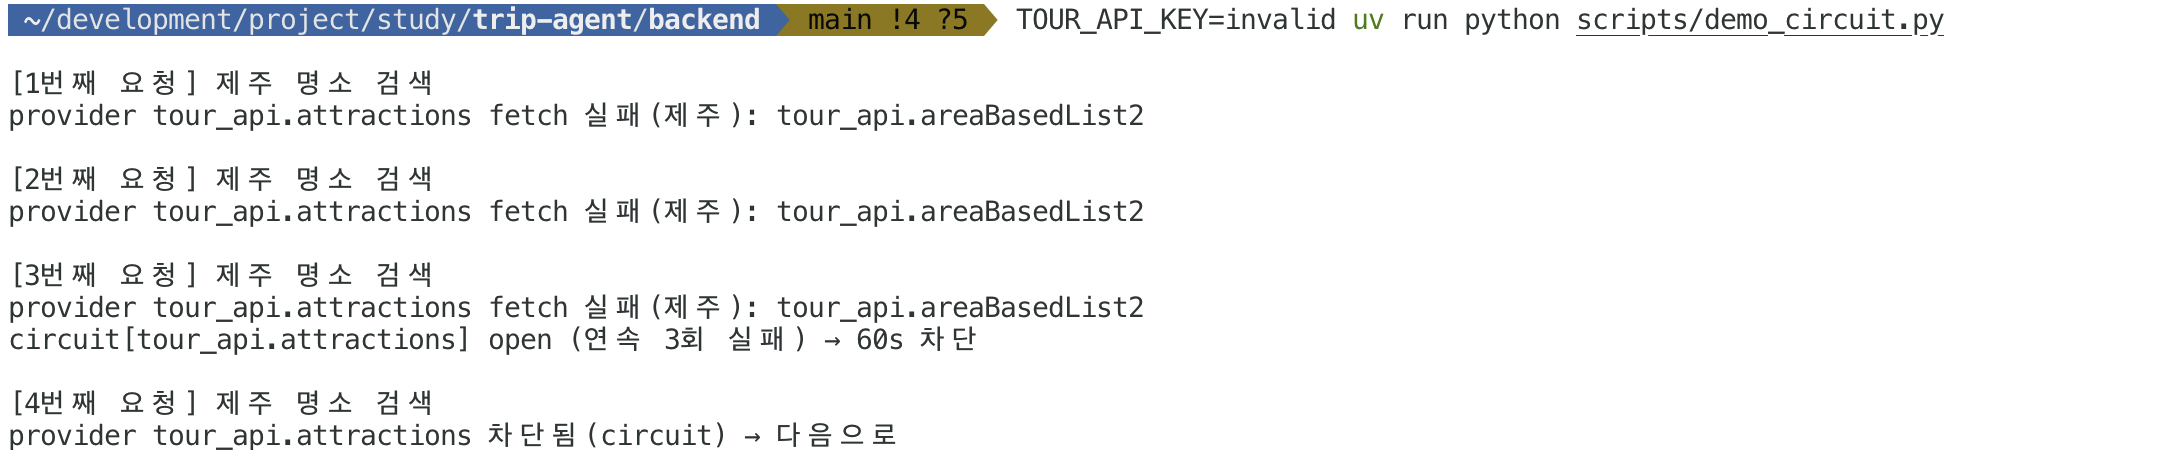
고치고 나서 키를 잘못된 값으로 바꿔 명소 검색을 네 번 돌려봤다. 세 번째에 열리고 네 번째는 provider를 아예 부르지 않는다.
half-open에서 시험 호출이 몰리지 않게
60초가 지난 뒤가 까다롭다. 여러 요청이 동시에 들어오면 전부 “이제 시험해봐도 되는 시간”이라고 판단해 죽어 있을지도 모르는 provider로 몰려간다.
def allow(self, name: str) -> bool:
    with self._lock:
        st = self._states.get(name)
        if st is None or not st.open_until:
            return True  # closed
        now = self._clock()
        if now < st.open_until:
            return False  # open → 차단
        st.open_until = now + self.cooldown  # 시험 1개 통과 + backstop 갱신
        return True
판단과 갱신을 락 안에서 한 번에 처리한다. cooldown이 지난 첫 요청이 통과하면서 open_until을 다시 60초 뒤로 밀어 두기 때문에 뒤따라온 요청은 다시 차단된다. 시험 호출이 하나만 나가는 셈이다.
밀어 둔 시간은 backstop 역할도 한다. 시험 호출이 어떤 이유로 성공도 실패도 보고하지 못하고 사라져도 60초 뒤에는 다음 시험이 허용되니 영구히 막히지 않는다. 다만 이 보장은 ‘호출 타임아웃 < 차단 시간’을 전제로 한다. 이 프로젝트는 provider 타임아웃이 60초보다 훨씬 짧아 성립하지만 초장기 호출을 다루는 곳이라면 따로 세대 관리가 필요하다.
시계는 time.monotonic을 주입받게 뒀다. 시스템 시각이 바뀌어도 흔들리지 않고 테스트에서는 가짜 시계를 넣어 60초를 기다리지 않고도 cooldown 경과를 재현할 수 있다.
FAQ 답변을 시맨틱 캐시로 재사용했다
환불이나 수하물 같은 정책 질문은 FAQ를 pgvector로 검색해 그 내용을 근거로만 답한다. 그런데 “예약 취소하면 환불 수수료는 어떻게 돼?”와 “예약 취소하면 환불 수수료는 어떻게 되나요?”처럼 어미만 다른 질문에도 매번 임베딩하고 검색하고 LLM으로 답을 새로 만들었다. 여기에 시맨틱 캐시를 얹었다.
def cache_lookup(embedding: list[float]) -> str | None:
    with _answer_cache_lock:
        best_ans, best_sim = None, 0.0
        for emb, ans in _answer_cache:
            sim = _cosine(embedding, emb)
            if sim > best_sim:
                best_sim, best_ans = sim, ans
        return best_ans if best_sim >= ANSWER_CACHE_MIN_SIM else None
캐시는 128개 상한의 FIFO다. 항목이 이 정도면 전부 훑어도 부담이 없어서 선형 탐색으로 뒀다. 상한을 키우거나 프로세스를 여러 개 띄우는 시점이 오면 FAQ 검색이 이미 쓰고 있는 pgvector로 옮기는 게 자연스럽다.
캐시를 조회하려면 지금 질문의 임베딩은 한 번 만들어야 한다. 히트하면 pgvector 검색과 답변 LLM을 건너뛰지만 임베딩 호출까지 없어지는 것은 아니다. 미스가 나면 캐시 조회용 임베딩을 만든 뒤 pgvector 검색 과정에서 같은 질문을 다시 임베딩한다. 현재 구현은 미스 경로에서 임베딩이 두 번 일어날 수 있다.
임계값은 보수적으로
정책 답변이라 잘못된 재사용이 제일 무섭다. 코사인 유사도 임계값을 0.95로 잡아 거의 같은 질문만 히트하게 했다. 임베딩 차원이 맞지 않으면 유사도를 0으로 떨어뜨려 미스로 처리한다. 모델을 바꾸거나 벡터가 손상됐을 때 엉뚱한 답이 히트하는 것보다 캐시를 못 쓰는 편이 낫다고 봤다.
0.95가 실제로 어느 정도인지 세 번 물어보면 드러난다. 어미만 바꾼 두 번째는 히트하고, 같은 뜻이지만 짧게 줄인 세 번째는 미스가 나 다시 검색으로 간다.
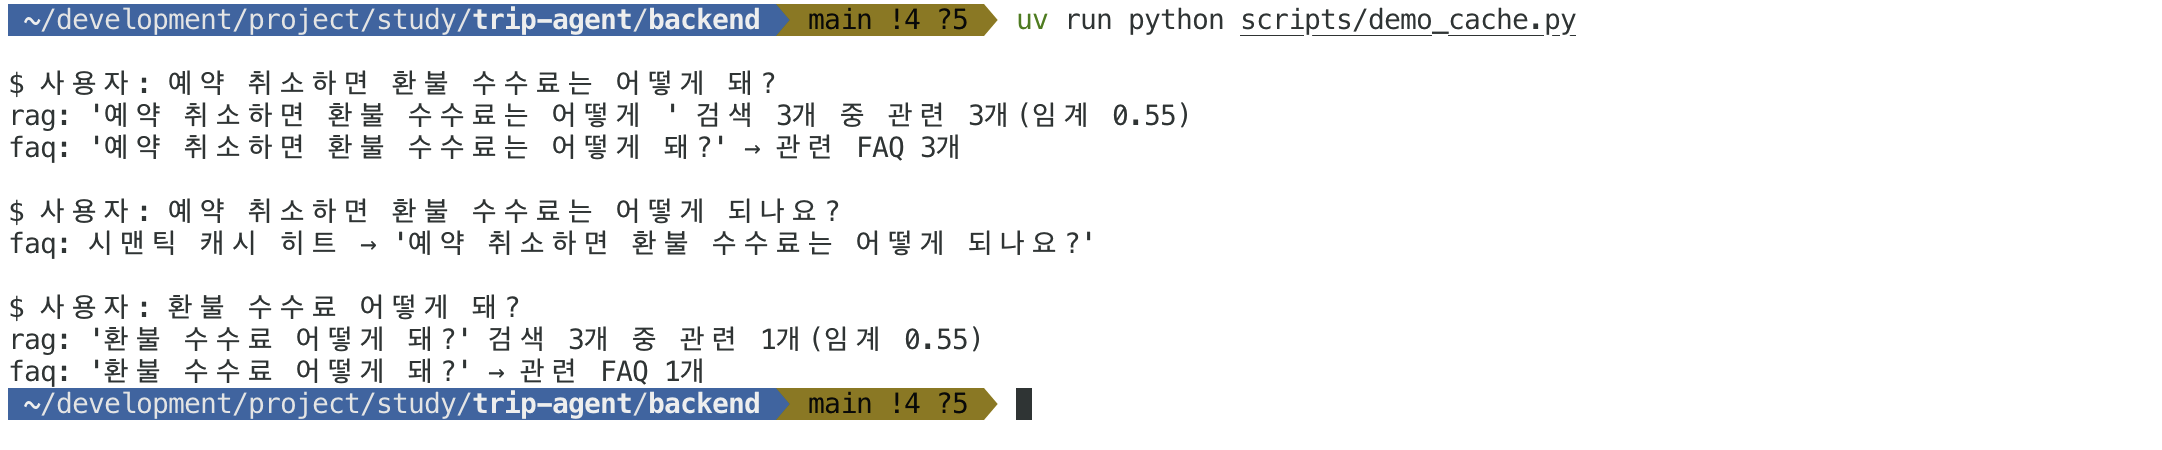
의도한 보수성이긴 한데 재사용 폭이 좁다는 뜻이기도 하다. 트래픽이 쌓이면 이 값을 다시 봐야 할 것 같다.
검색이 아무것도 찾지 못한 결과는 캐시하지 않는다. 임계 근처에 있던 질문이 나중에 FAQ가 추가되면서 실제로 걸릴 수 있는데 그때 캐시된 “못 찾음”이 검색 자체를 막아버리기 때문이다.
재적재와 부딪히지 않게
FAQ 데이터를 다시 넣으면 캐시를 비운다. 이때 이미 진행 중이던 요청이 문제가 된다. 옛 FAQ로 검색해 만든 답변이 캐시를 비운 뒤에 저장되면 낡은 답이 새 캐시에 들어앉는다.
세대 카운터로 막았다. 요청이 검색을 시작할 때 현재 세대를 캡처해 두고 저장할 때 그 값을 함께 넘긴다.
gen = rag_service.current_generation()  # search가 볼 FAQ 세대
results = rag_service.search_faq(query, top_k=3)
...
rag_service.cache_store(q_emb, answer, gen)cache_store는 넘어온 세대가 지금 세대와 다르면 저장하지 않고 그냥 버린다. 재적재가 끼어든 요청의 답변은 캐시에 남지 않는다.
캐시가 실패해도 답변은 나가게
조회와 저장 모두 try 안에 두고 예외가 나면 로그만 남기고 정상 경로로 진행한다. 임베딩 호출이 실패하든 캐시가 이상하든 사용자는 답변을 받아야 한다. 캐시는 있으면 빨라지는 장치지 답변의 전제가 아니다.
재지 않은 것
밝혀 둘 게 있다. 캐시 히트율이나 절감한 호출 수, 서킷브레이커 적용 전후의 응답 지연은 재지 않았다. 혼자 돌리는 데모라 의미 있는 트래픽이 없어서 숫자를 내도 해석하기 어렵다고 봤다. 그러니 이 글의 셋은 효과를 측정해 검증한 결과가 아니라 겪은 문제에 맞춰 고른 선택에 가깝다. 실제 서비스였다면 적용 전후를 비교할 지표도 함께 설계했을 것 같다.
트레이스가 보여주는 지연과 체감은 다르다
이 프로젝트는 응답을 SSE로 흘려보낸다. 사용자가 느끼는 건 전체 시간뿐 아니라 첫 text_delta가 언제 도착하느냐(TTFT)와 그 뒤의 델타가 얼마나 고르게 이어지느냐(ITL)에 가깝다. 40초가 걸린 응답이라도 2초 만에 첫 문장이 시작되어 끊김 없이 이어지면 기다릴 만하다. 반대로 20초 동안 아무것도 없다가 한꺼번에 쏟아지면 멈춘 것처럼 보인다.
LangSmith에서도 스트리밍 LLM 호출의 첫 토큰 시간은 볼 수 있다. 하지만 사용자가 느끼는 TTFT는 그래프 실행과 SSE 전송을 거쳐 브라우저가 첫 text_delta를 받은 시각이다. 이 구간 전체와 이후 델타 간격을 재려면 스트림을 받는 쪽에서 시각을 직접 기록해야 한다. 아직 그 계측을 넣지 않았다.
평균만 보는 것도 부족하다. 골든셋에서 케이스별 소요가 15초에서 64초까지 벌어졌지만 그건 작업 난이도가 달라서 생긴 차이다. 같은 요청이 때에 따라 얼마나 늘어지는지는 아직 모른다. 꼬리 지연은 대표 요청을 충분히 모으거나 같은 조건으로 반복해서 재야 나온다. p95나 p99가 몇 초인지 모르는 상태에서는 느린 요청이 사용자 경험에 얼마나 영향을 주는지도 짐작에 머문다.
동시에 들어올 때를 재현해보지 않았다
부하 테스트도 하지 않았다. 그런데 앞에서 만든 장치 중 일부는 동시 요청이 있어야 의미가 드러난다. 서킷브레이커의 half-open 처리는 여러 요청이 같은 순간에 “이제 시험해도 되는 시간”이라고 판단할 때를 위한 것이다. 혼자 눌러보는 데모에서는 그 경로가 거의 밟히지 않으니 락으로 막아둔 부분이 실제로 제 역할을 하는지는 유닛 테스트 밖에서 확인된 적이 없다.
캐시도 마찬가지다. 지금 구현은 같은 질문이 동시에 여러 개 들어오면 각각 임베딩하고 검색해서 각자 답을 만든 뒤 마지막에 캐시에 쓴다. 진행 중인 계산을 공유해 뒤따라온 요청이 기다렸다 결과를 받아가는 처리는 없다. 트래픽이 몰리는 상황에서야 이게 비용으로 보일 텐데 그 상황을 만들어보지 않았으니 지금은 짐작만 하고 있다.
대신 동작 자체는 유닛 테스트로 확인했다. 서킷브레이커는 연속 실패로 열리는지, cooldown이 지나면 시험 호출 하나만 통과하는지, 성공하면 닫히는지를 가짜 시계로 검증한다. 캐시는 임계값 위아래에서 히트와 미스가 갈리는지, 차원이 다르면 미스가 되는지, 세대가 바뀌면 저장이 무시되는지를 본다.
공통 provider 호출에서는 장애 세 번 뒤 네 번째 호출을 건너뛰는지, 빈 결과와 구현 오류는 서킷을 열지 않는지를 확인했다. Duffel은 HTTP 장애와 빈 항공편을 구분하는지 검증했다. 자연어로 항공편을 물었을 때는 추출한 도시만 provider에 넘기고 국내 검색이 사이에 끼어도 기존 실패 횟수를 지우지 않는지까지 봤다. 실 LLM 없이 도는 테스트라 2편에서 적은 유닛 계층에 함께 들어가 있다.
..................................                                       [100%]
34 passed in 0.04s
직접 만든 것과 맡길 수 있는 것
지금 구조에는 직접 짠 계층이 둘 있다. 하나는 LLM 팩토리다. 에이전트 역할을 reasoning·standard·fast 티어로 나누고 티어별 전용 엔드포인트 설정이 있으면 그걸 쓴다. 없으면 공용 설정을 보고 그것도 없으면 OpenAI 직접 설정을 고른다. 모두 OpenAI 호환이라 ChatOpenAI 하나로 처리한다.
tier = AGENT_LLM_MAP.get(role, "standard")
base_url, api_key, model = settings.resolve_tier(tier)
이 자리는 LiteLLM 같은 LLM 게이트웨이가 맡을 수 있는 부분이다. 게이트웨이를 앞에 두면 모델 라우팅과 런타임 폴백뿐 아니라 요청별 비용 집계, 키 관리, rate limit, 재시도 정책을 한곳에서 다룰 수 있다. 지금은 설정을 고르는 순서만 코드에 있고 비용이 얼마나 나가는지는 따로 집계하지 않는다. 대신 홉이 하나 늘고 게이트웨이를 단일 인스턴스로 두면 그곳이 멈췄을 때 전체 LLM 호출도 멈춘다. 티어가 셋이고 설정 규칙이 단순한 지금 규모에서는 코드 안의 설정으로 충분하다고 판단했다.
다른 하나는 프롬프트다. 지금은 저장소 안의 템플릿 파일을 render(name, **variables)로 읽어 쓴다. 프롬프트를 고치려면 코드를 고치고 배포해야 한다는 뜻이다. 프롬프트 레지스트리를 쓰면 버전을 붙여 롤백하거나 배포 없이 문구를 바꾸고 버전별로 나눠 비교하는 일이 가능해진다. 2편의 골든셋과 묶으면 “이 프롬프트 버전의 통과율”을 버전마다 남길 수도 있다.
다만 프롬프트가 코드 밖으로 나가면 변경 이력과 리뷰를 저장소가 아닌 다른 곳에서 챙겨야 한다. 지금은 프롬프트를 만질 때마다 골든셋을 돌려보는 흐름이라 코드와 같이 두는 쪽이 편했다. 프롬프트를 자주 바꾸거나 나 말고 다른 사람이 손대기 시작하면 그때 옮길 자리로 보고 있다.
남은 것
서킷브레이커와 시맨틱 캐시는 프로세스 메모리에 상태를 두는 경량 구현이다. 워커를 여러 개로 늘리면 두 상태가 워커마다 따로 논다. 한 워커가 차단한 provider를 다른 워커는 계속 부르게 된다. 그때는 공유 저장소로 옮겨야 한다. 캐시는 pgvector가 이미 있으니 그쪽으로 옮길 수 있고 서킷브레이커 상태는 별도 스토어가 필요하다.
각 선택에는 비용도 있었다. 트레이싱을 쓰면 프롬프트와 응답이 외부로 나갈 수 있다. 서킷브레이커에는 구현 복잡도와 정상 provider를 잠시 건너뛸 가능성이 따라온다. 캐시에는 TTL이 없어서 재적재 경로를 거치지 않고 FAQ가 바뀌면 오래된 답변이 그대로 남는다. 만들 때는 잘 보이지 않던 셋이 데모를 돌려보고 나서야 눈에 들어왔다.
참고
여행 챗봇 시리즈
- #llm
- #observability
- #circuit-breaker
- #cache
- #langgraph