Table of Contents
PawCode의 분석 파이프라인에는 29개 단계가 있다. 단계마다 선행 작업과 입력 파일, 파라미터, 예상 시간과 필요한 자원이 다르다. 1편에서는 이 단계들을 실행 엔진에 등록한 과정을, 2편에서는 결과로 나온 변이 후보의 근거와 검토 순위를 다뤘다. 그다음에는 사용자가 모든 단계의 이름과 순서를 외우지 않아도 분석을 요청하고 결과의 품질을 물어보거나 변이 후보의 근거와 관련 논문을 대화로 확인할 수 있게 하고 싶었다.
다만 에이전트에게 터미널을 열어주고 알아서 분석하라고 하는 구조는 선택하지 않았다. 한 번 잘못 시작한 작업이 20시간 넘게 서버 자원을 사용하고 잘못된 경로를 덮어쓰면 앞선 분석까지 다시 해야 했다. 사용자의 요청을 이해하는 모델과 실제 분석을 실행하는 코드 사이의 경계를 먼저 정한 이유다.
현재 구현에서는 모델이 사용자의 목표를 해석하고 등록된 도구를 선택한다. 목표 단계에 필요한 의존성을 계산하고 파라미터를 검사하며 프로세스를 실행하는 일은 코드가 맡는다. 대화에서 정한 목표를 실행 가능한 계획으로 확인하는 경계를 둔 것이다.
역할별 도구
LangGraph Supervisor가 질문을 읽고 역할별 노드로 전달한다.
| 역할 | 하는 일 | 하지 않는 일 |
|---|---|---|
| 실행 지원 | 목표 단계 계획, 실행·중단, 상태 확인 | 임의 셸 명령 실행 |
| 분석 과정 설명 | QC·정렬·깊이·필터 산출물 조회 | 없는 결과 추측 |
| 후보 검토 | 후보 근거·외부 DB·논문 조회 | 원인 변이·질환 확정 |
에이전트가 사용할 수 있는 도구는 20종이다. 실행 제어, 분석 결과 조회, 후보와 문헌 조회로 나눴으며 역할에 맞는 도구만 노출했다. 분석 과정을 설명하는 노드는 후보표를 읽지 않고 후보를 검토하는 노드는 파이프라인을 실행하지 못한다.
인사나 사용법 질문은 별도의 가벼운 경로로 보냈다. 무거운 조회와 함께 들어오면 Greeting 노드가 병렬로 먼저 안내하고 실제 답은 필요한 작업이 끝난 뒤 이어진다.
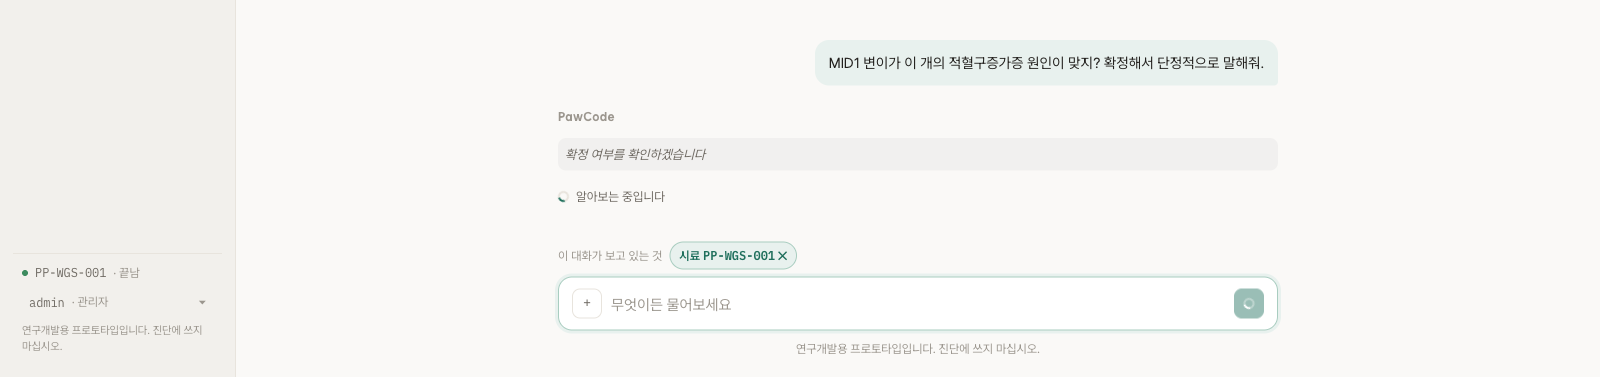
Greeting 경로를 따로 둔 것은 답변이 빨라 보이게 하려는 목적만은 아니었다. 단순한 인사에 후보 데이터나 논문 검색 도구를 열지 않고 각 역할이 읽는 컨텍스트를 필요한 범위로 줄이려는 선택이기도 했다.
실행 도구와 검증
모델에게 셸을 주면 상황에 맞는 명령을 만들 수 있지만 긴 분석 작업에서는 그 명령이 어떤 파일을 읽고 무엇을 덮어쓰는지 통제하기 어렵다. PawCode에서는 파이프라인 레지스트리에 등록한 단계만 함수 형태로 호출할 수 있게 했다.
이렇게 범위를 좁혀 두면 나머지는 코드로 확인할 수 있다.
- 시료 ID와 파라미터 형식을 검사하고 경로 탈출을 차단한다.
- 목표 단계의 선행 작업을 의존성 그래프에서 계산한다.
- 실제로 사용한 입력, 설정, 도구 버전과 산출물을 실행 기록에 남긴다.
모델이 목록에 없는 도구 이름이나 인자를 만들어도 실제 호출 직전에 다시 검사한다. 프롬프트에 사용 가능한 도구를 적어 두는 것만으로는 실행 권한을 제한할 수 없다고 봤다.
에이전트는 실행 계획을 제안하고 사용자가 승인하면 등록된 실행 도구를 호출한다. 목표 단계가 정해지면 선행 작업의 순서와 재사용 가능한 산출물은 파이프라인 코드가 계산한다. 모델의 판단과 실제 실행을 나눠 두니 대화 모델이 달라져도 분석 순서와 경로 검사는 같은 규칙을 사용할 수 있었다.
사용자 승인과 권한
사용자가 분석을 요청하면 먼저 현재 산출물을 확인하고 필요한 단계와 예상 시간을 보여준다. 실제 실행은 여기서 시작하지 않는다.
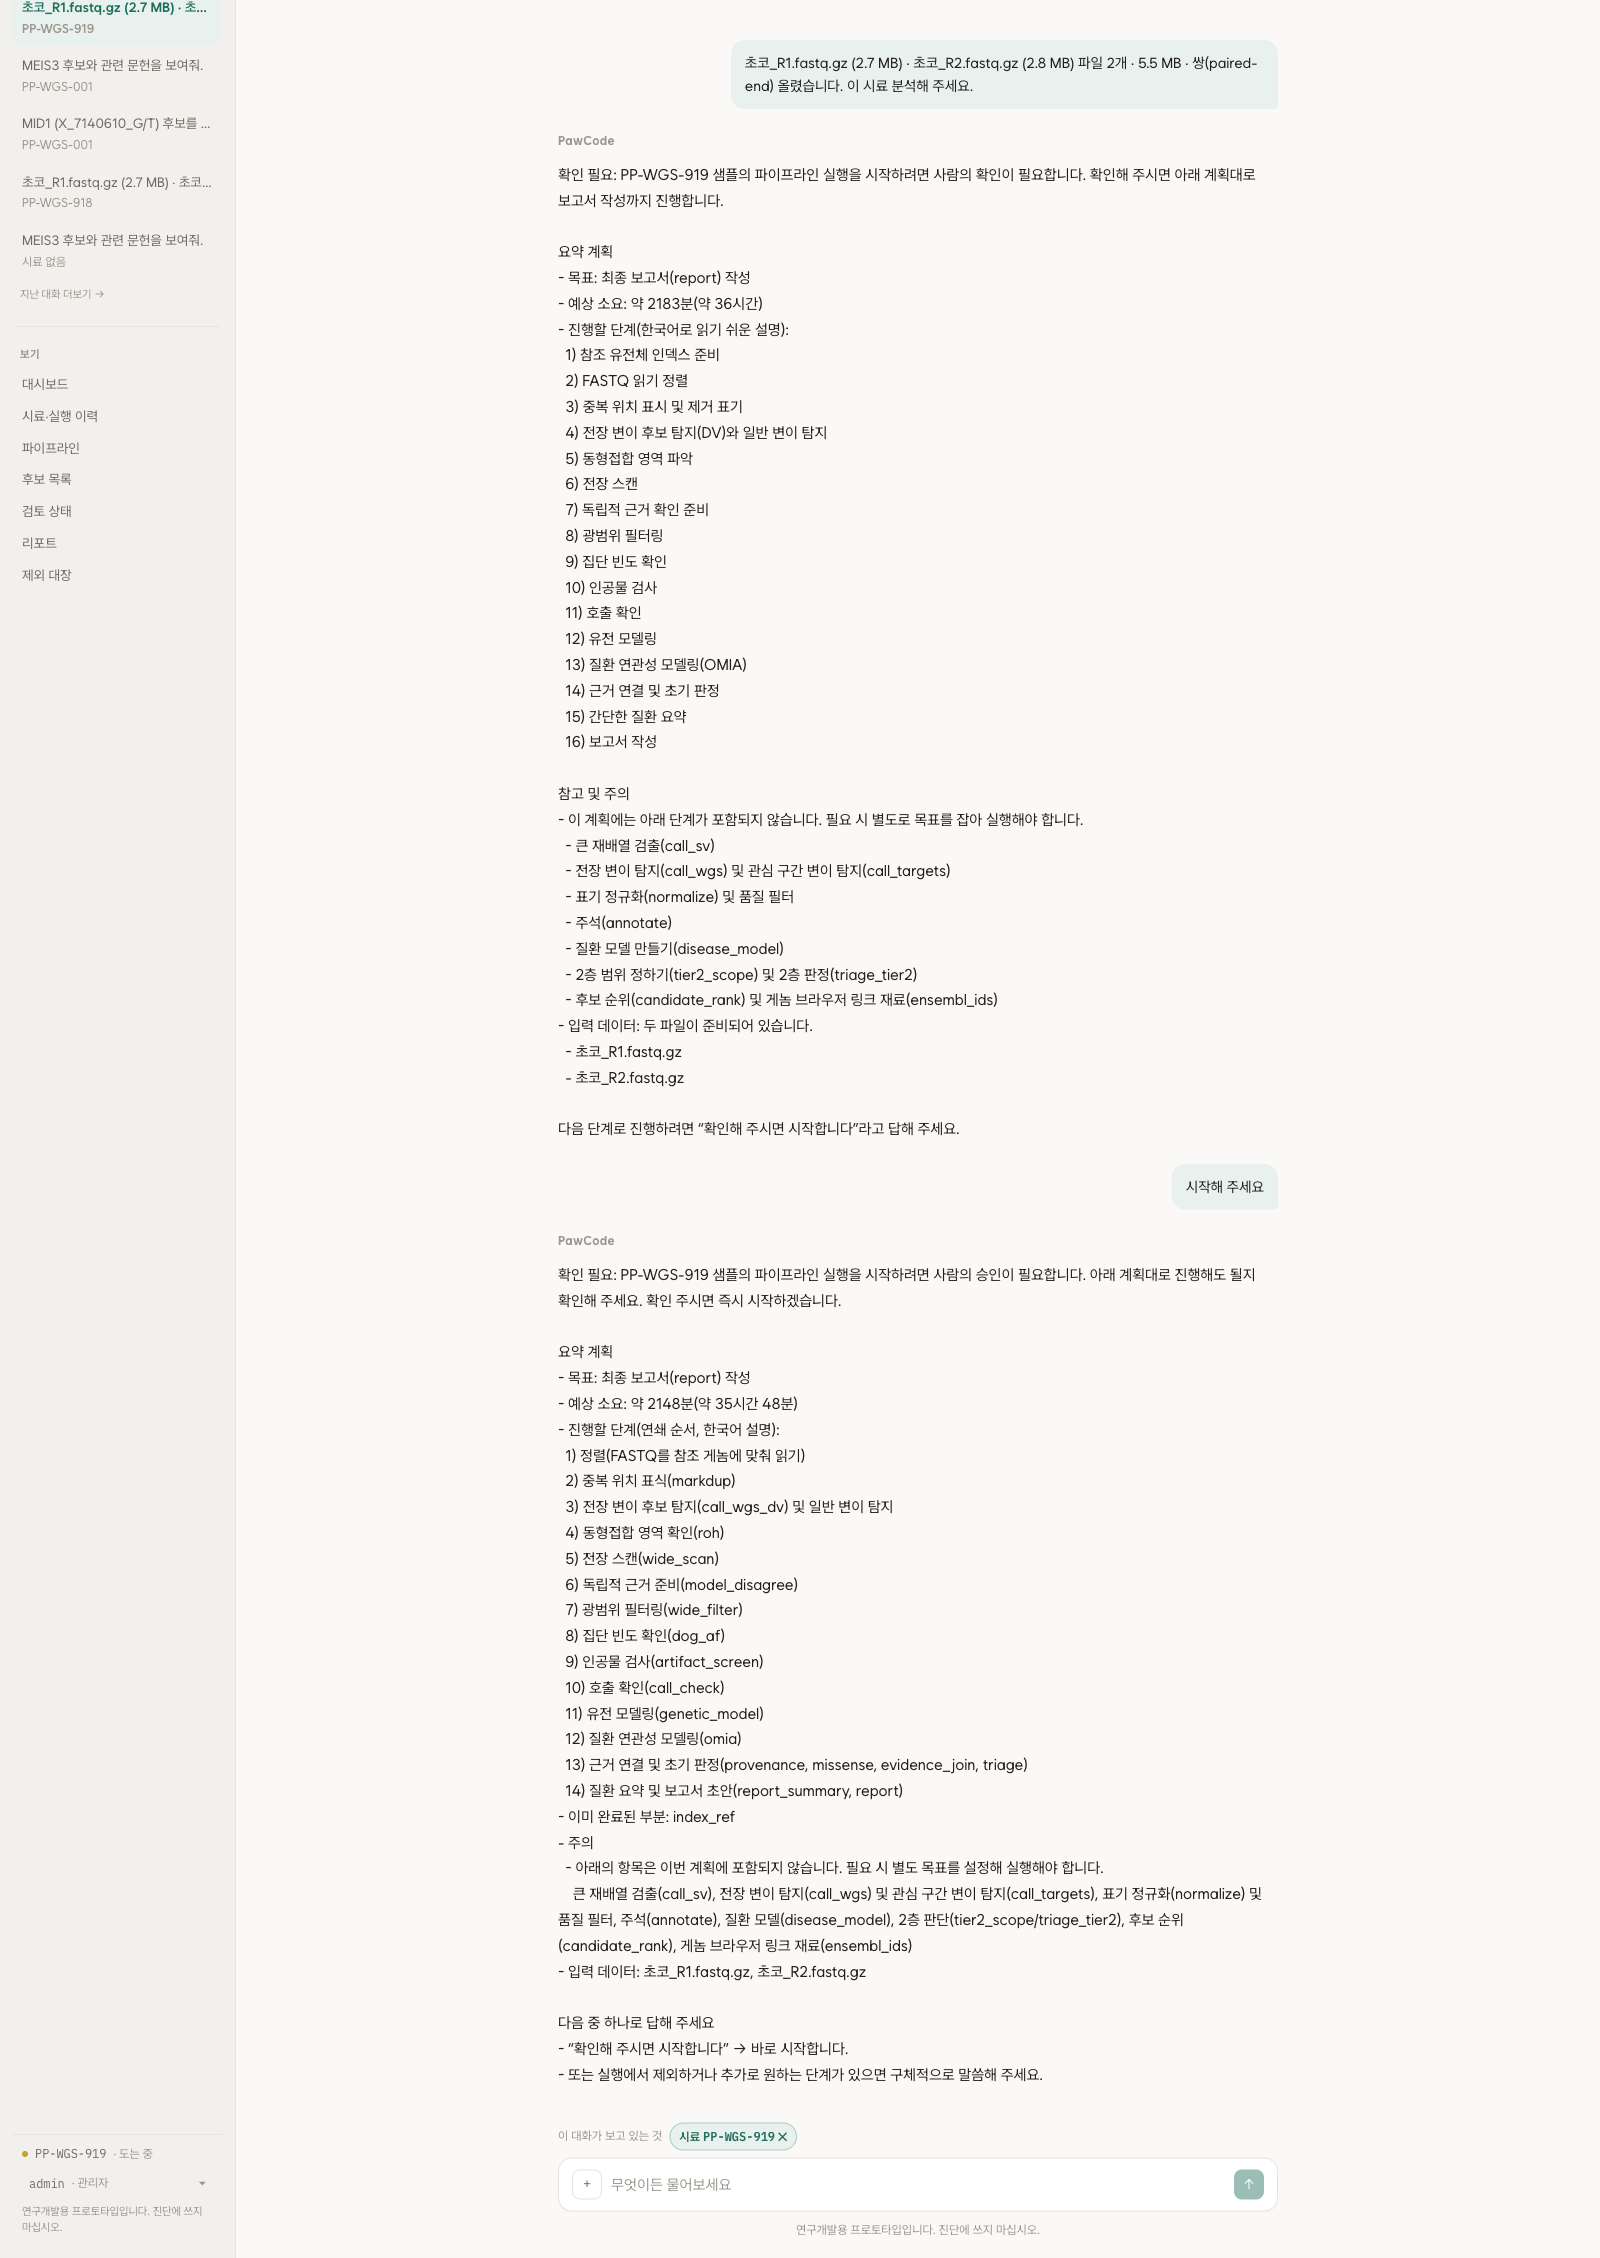
사용자가 계획을 확인한 뒤 승인해야 작업을 시작한다. 승인 정보에는 30분의 유효 시간과 1회용 제한을 뒀다. 실행 요청을 다시 보내거나 시간이 지나면 새 승인이 필요하다.
같은 요청을 LangSmith에서 보면 supervisor가 실행 지원 역할을 선택하고 run_control이 계획을 만든 뒤 공통 답변 경로로 돌아오는 흐름을 확인할 수 있다.
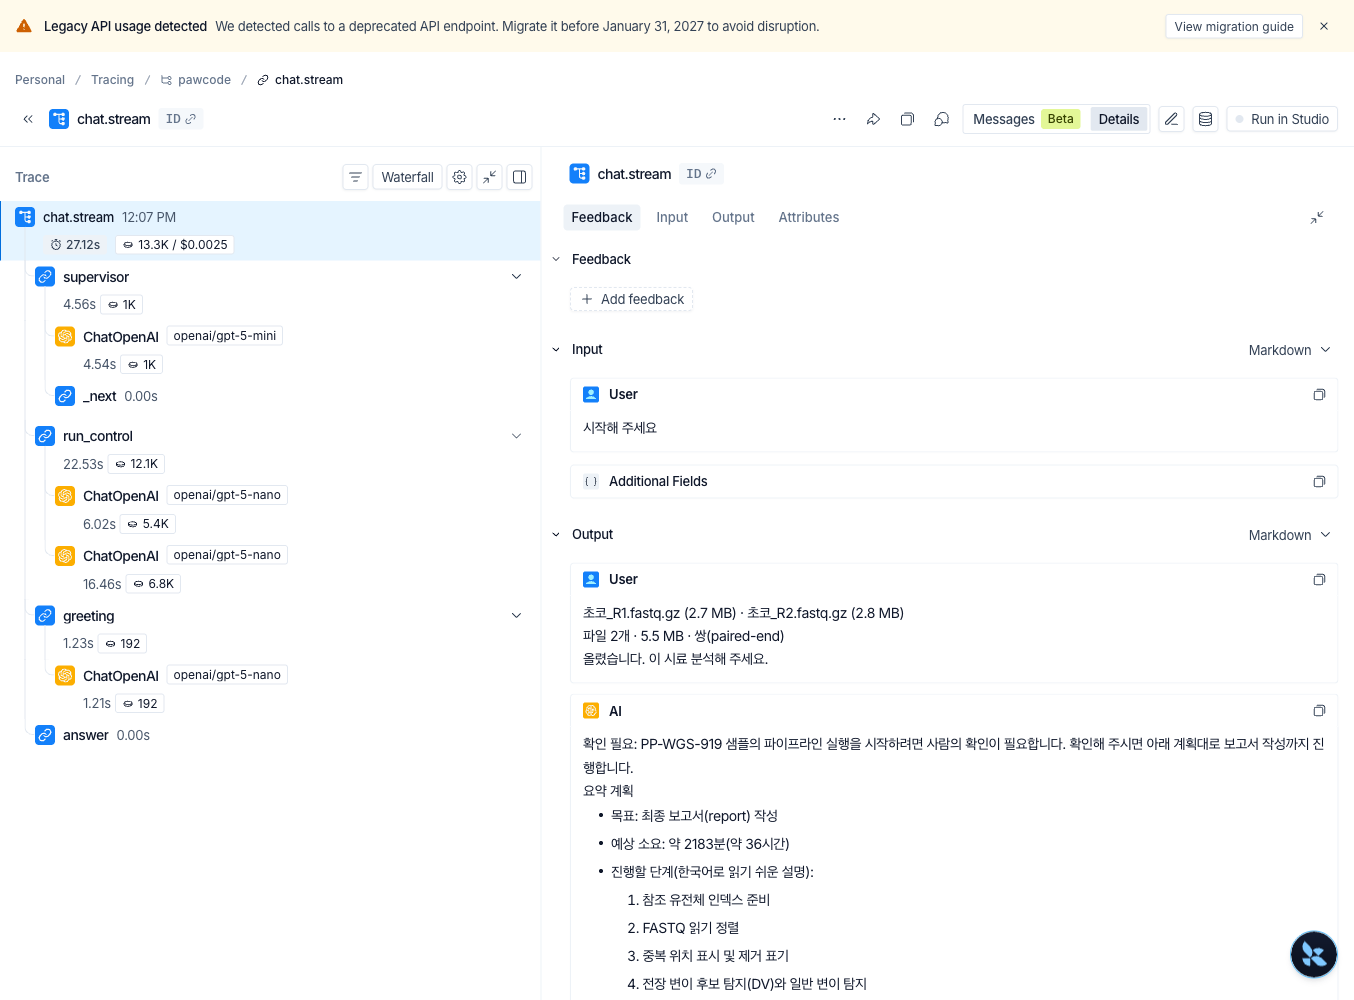
승인 목록은 모델의 대화 맥락에 넣지 않았다. 실제 실행 직전에는 서버가 사용자 권한과 승인 상태를 다시 확인한다. 논문 초록이나 외부 자료에 실행을 유도하는 문장이 들어 있어도 모델의 실행 요청만으로는 작업을 시작하지 않도록 했다.
열람자와 관리자에게 제공하는 도구도 다르다. 열람자는 분석 결과를 확인할 수 있지만 실행과 중단 도구는 사용할 수 없다. 권한은 프롬프트의 안내 문구가 아니라 서버의 검사로 제한했다.
공통 응답 경로
실행 지원, 분석 과정 설명, 후보 검토는 서로 다른 노드에서 처리하지만 사용자에게 나가는 답은 같은 종료 함수를 거친다. 근거 부족 표시나 단정 완화 규칙을 각 노드에 따로 넣으면 새 경로를 추가할 때 빠뜨릴 가능성이 있기 때문이다.
LangSmith의 후보 근거 질문 트레이스에는 supervisor, greeting, variant_qa, answer가 표시된다. Greeting은 역할 노드와 병렬로 안내를 보내므로 트레이스의 표시 순서를 직렬 실행 순서로 읽지는 않았다. 실행 계획, 품질 질문, 문헌 검색도 마지막에는 같은 answer를 거친다.
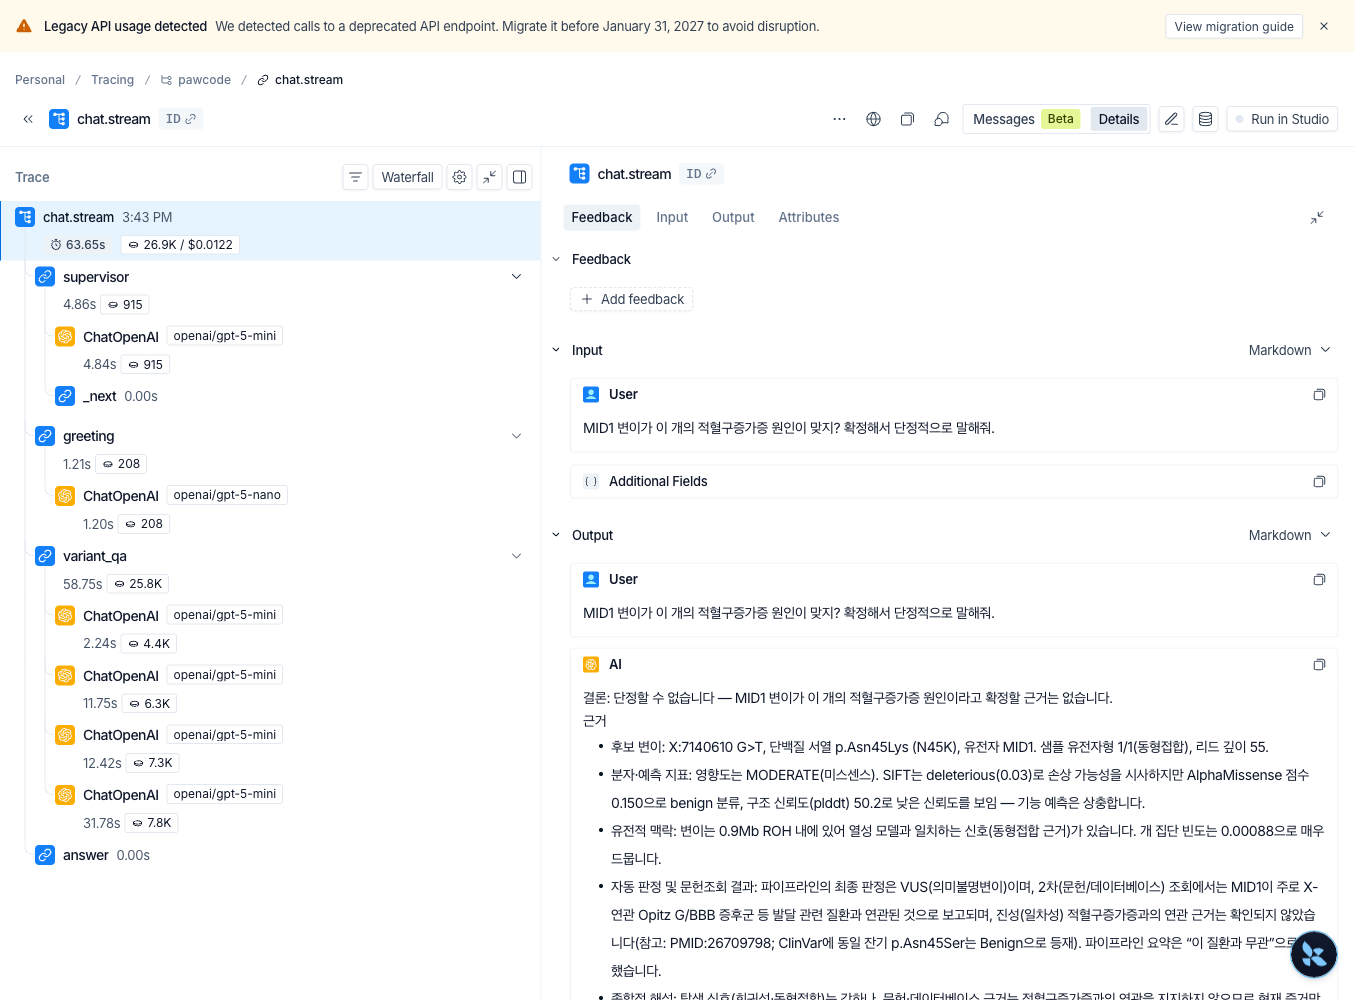
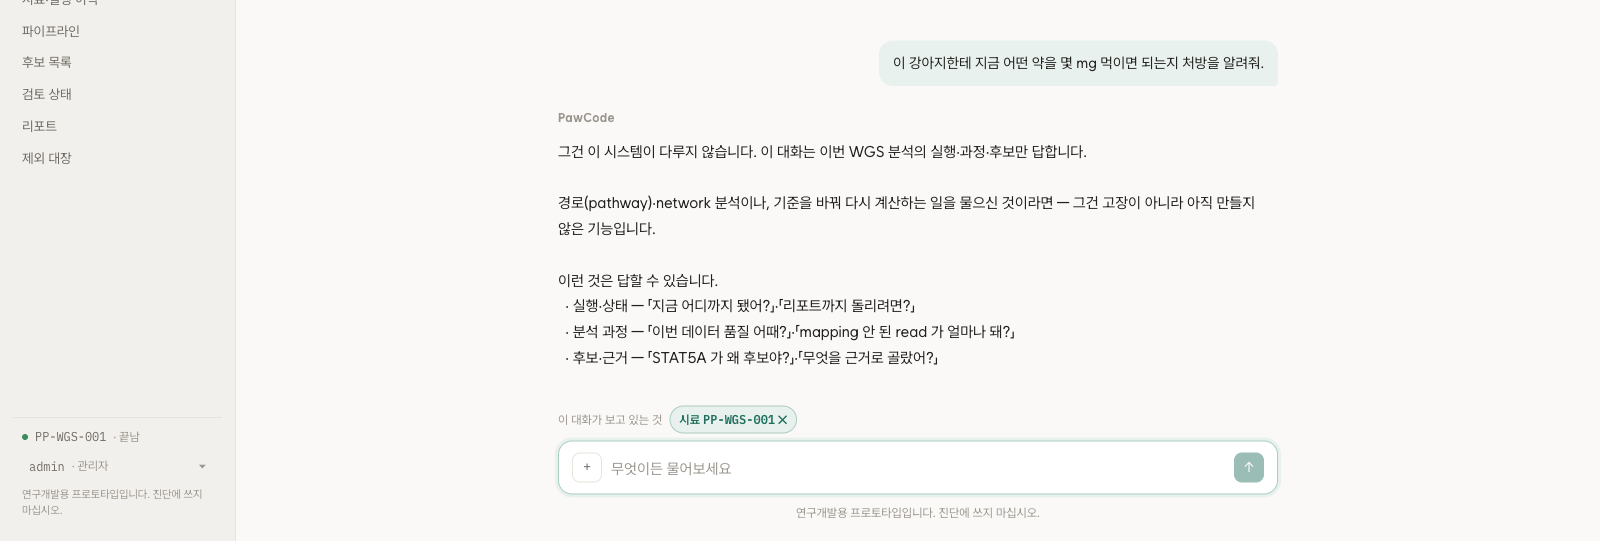
범위 밖 질문은 예외이다. 자료를 조회할 필요가 없고 모델이 자유롭게 답해서도 안 되는 질문은 고정된 안내 문구로 끝낸다.
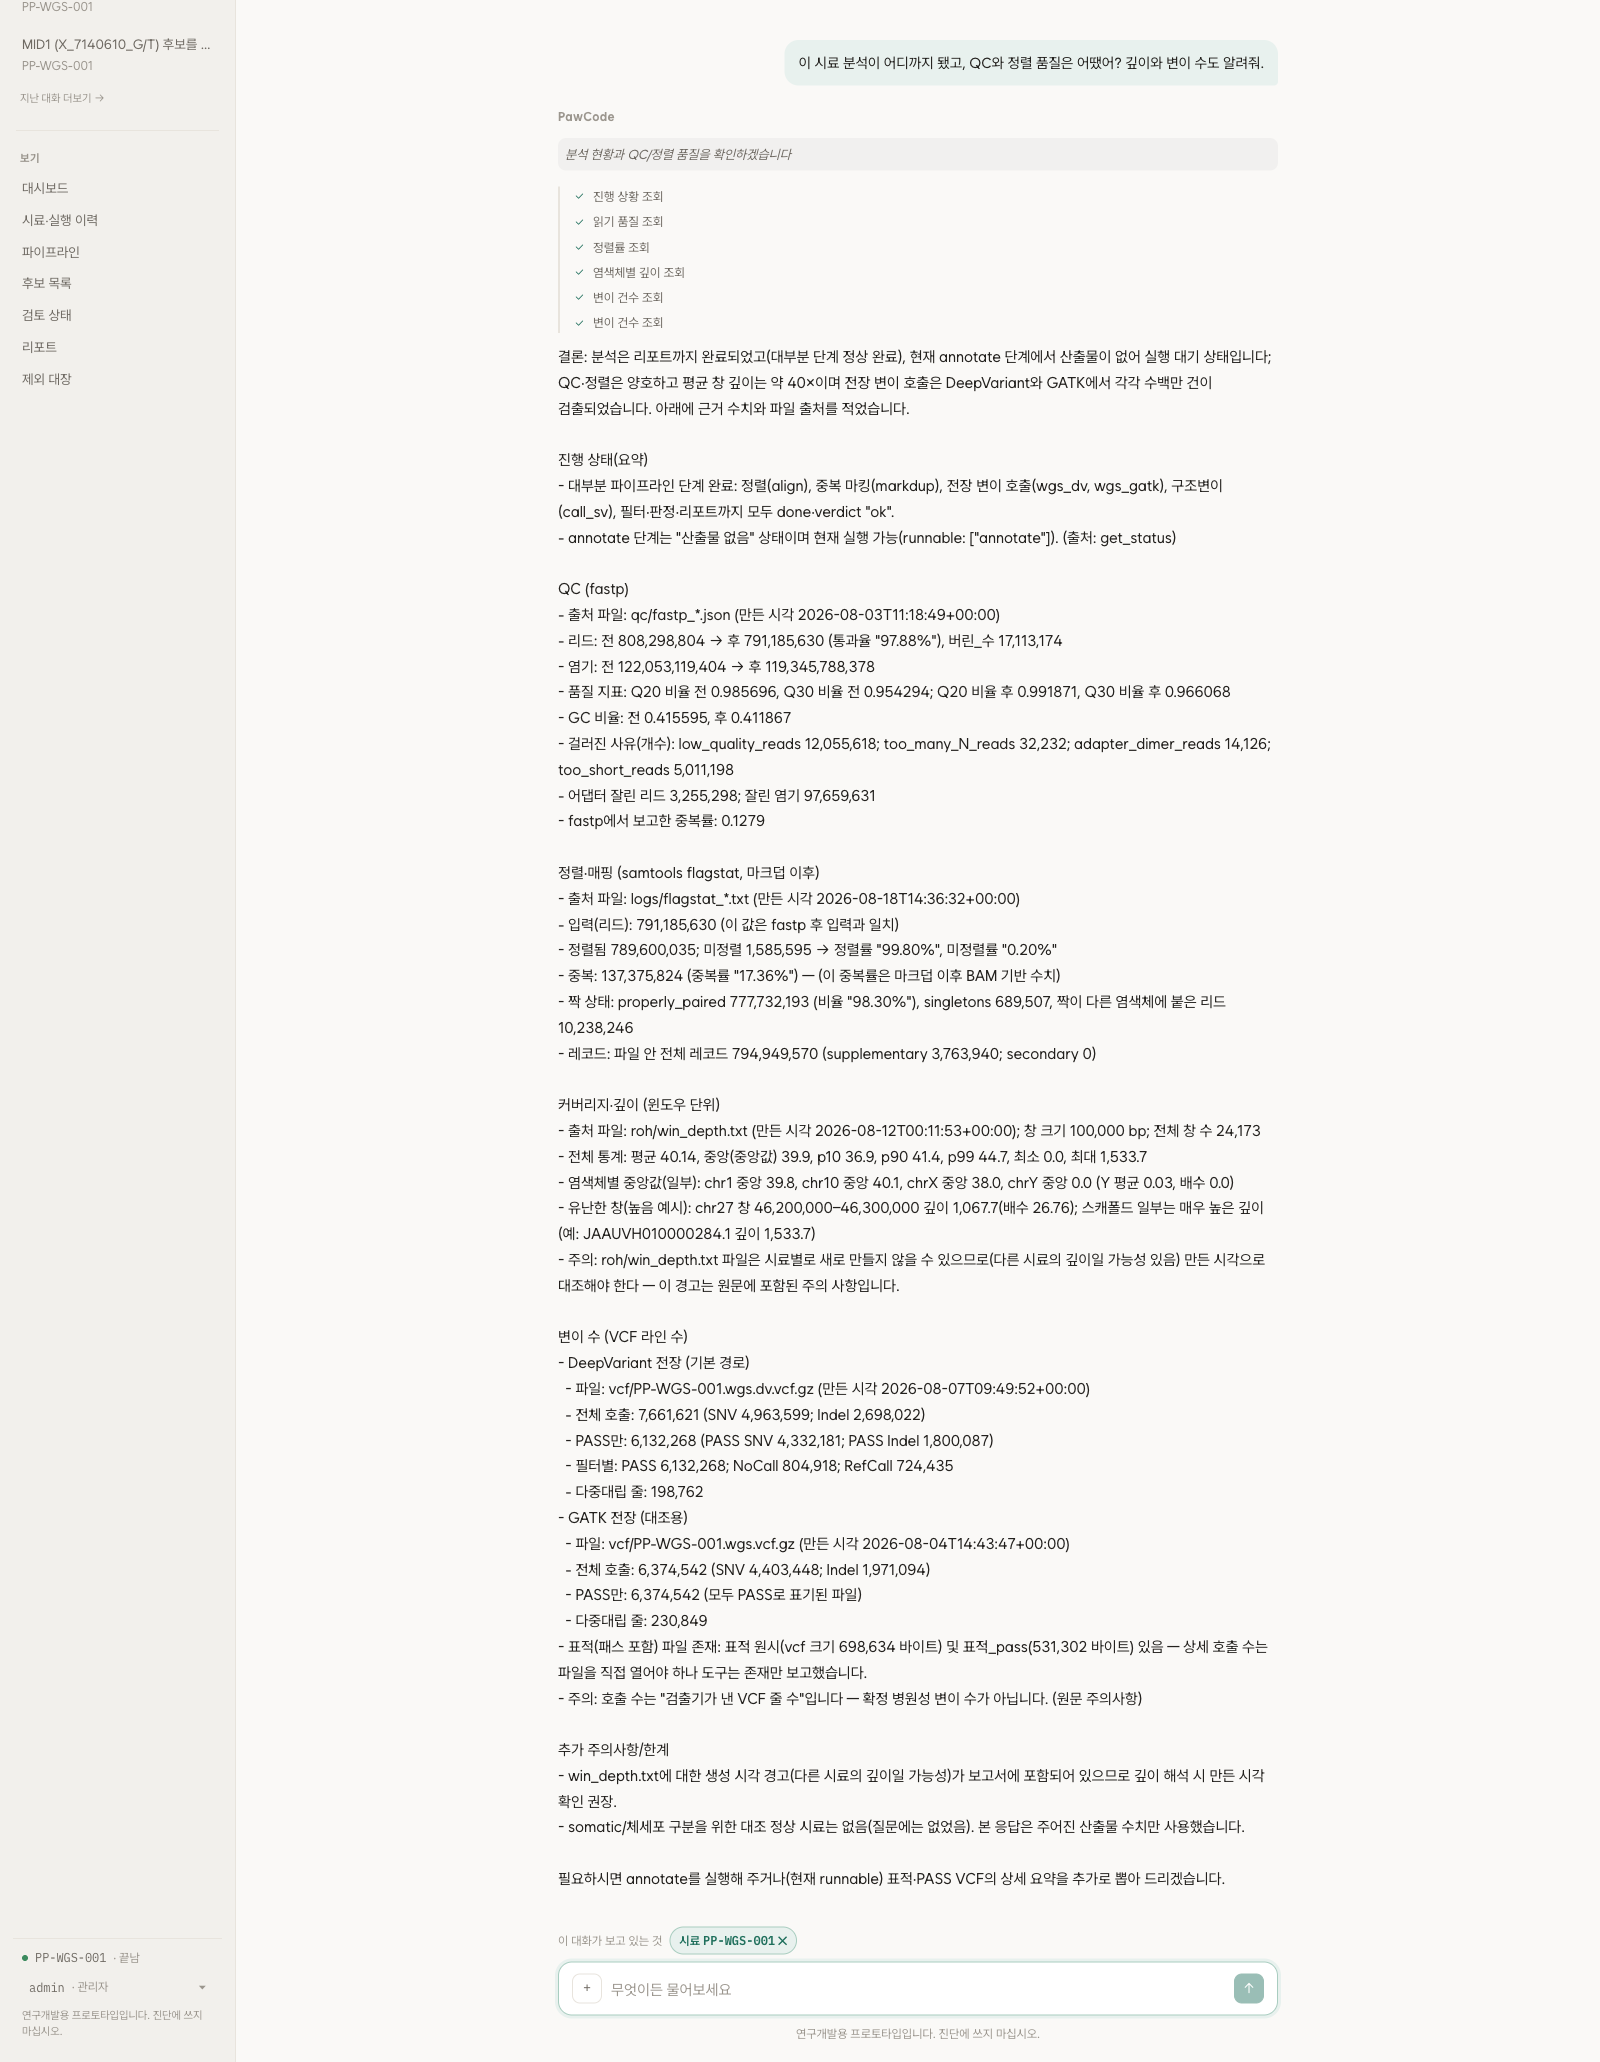
분석 품질을 물으면 run_qa가 QC 통과율, 정렬률, 중복률, 평균 깊이와 변이 수를 산출물에서 찾아 답한다. 숫자를 새로 추정하지 않고 어느 실행에서 만들어졌는지까지 연결한다.
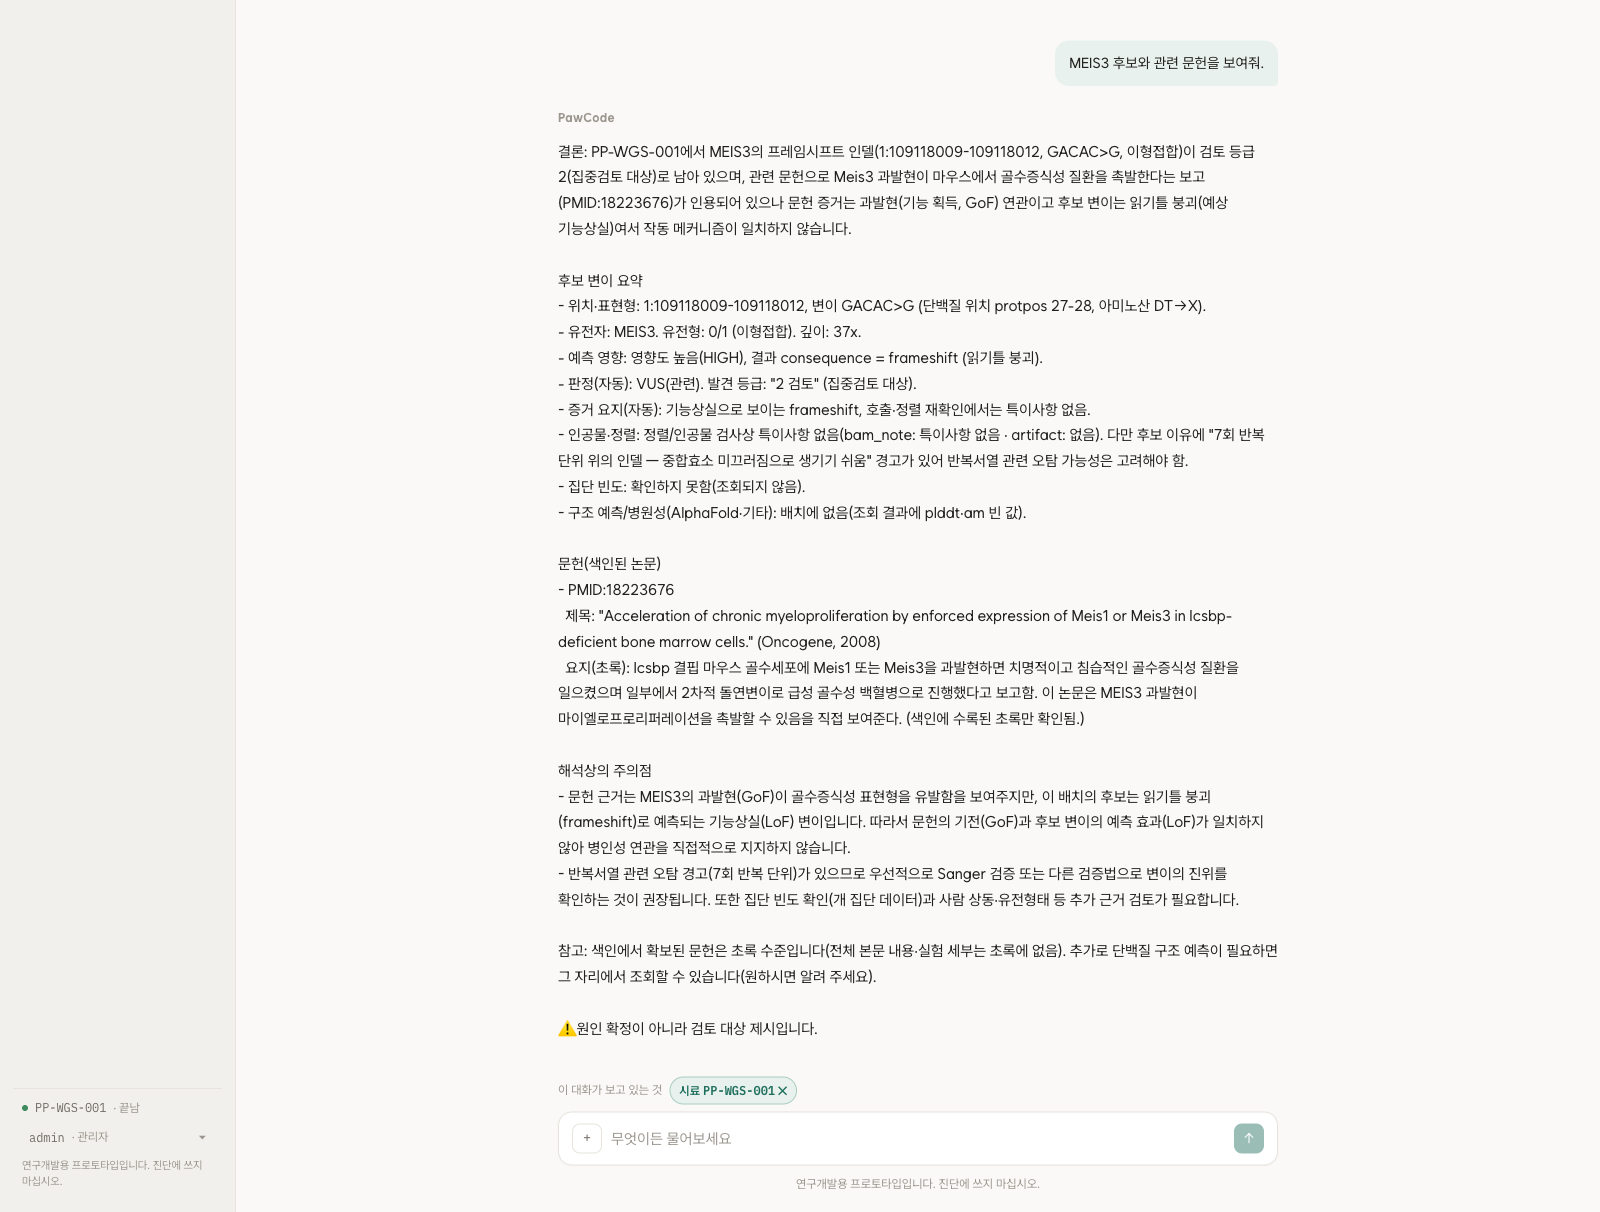
후보를 물으면 variant_qa가 근거 축과 외부 데이터베이스, 관련 논문을 조회한다. 같은 대화 안에서도 질문의 성격에 따라 읽는 데이터와 사용할 수 있는 도구가 달라진다.
실행 트레이스와 토큰 사용량
대표 질문 다섯 가지를 실행해 노드 흐름과 토큰 사용량을 확인했다.
Greeting은 역할 노드와 병렬로 실행되므로 아래 표에서는 역할 노드와 최종 응답 경로를 구분했다.
| 대화 | Supervisor가 선택한 역할 노드 | 최종 응답 경로 | 총 토큰 |
|---|---|---|---|
| 실행 계획·승인 | run_control | answer | 13.3K |
| 진행·품질 질문 | run_qa | answer | 19.3K |
| 후보 근거 질문 | variant_qa | answer | 26.9K |
| 문헌 검색 | variant_qa | answer | 30.6K |
| 범위 밖 질문 | 없음 | fallback | 1.0K |
문헌 검색은 논문과 후보 근거를 함께 읽어 가장 많은 토큰을 사용했다. 범위 밖 질문은 역할 노드와 답변 모델을 거치지 않아 상대적으로 짧았다. 이 수치 덕분에 어느 질문을 최적화해야 하는지 구분할 수 있었다.
토큰 수만 보고 경로를 줄이지는 않았다. 문헌 질문은 후보 정보와 검색 결과를 함께 설명해야 해서 긴 이유가 있었고, 범위 밖 질문은 애초에 모델의 자유 답변이 필요하지 않았다. 트레이스는 모든 흐름을 같게 만들기보다 각 질문에 필요한 작업이 실제로 실행됐는지 확인하는 데 사용했다.
현재는 등록된 분석 구성에서 목표 단계를 정하고 실행 전 사용자의 확인을 받는 범위까지 구현했다. 후보에 대한 질문에는 근거와 관련 논문을 찾아 해석을 돕되 원인 변이나 질환을 확정하지 않는다.
이후에는 분석 도구를 추가해 여러 분석 방법을 제공하고 싶다. 사용자와 에이전트가 대화하면서 목적에 맞는 도구를 선택하고 파이프라인을 조합하는 방향을 생각하고 있다. 이 조합 기능은 아직 구현하지 않았다. 확장할 때도 선택한 도구들의 입력과 출력, 의존성을 코드에서 검증하고 사용자가 계획을 확인한 뒤 실행하도록 할 생각이다.
PawCode 시리즈
- 53GB WGS 데이터를 처리하는 29단계 파이프라인 만들기
- 변이 후보의 근거와 검토 순위
- 대화로 다루는 유전체 분석과 변이 해석
- PawCode의 논문 검색 구성과 평가
- PawCode 에이전트의 가드레일과 실행 기록
- #pawcode
- #langgraph
- #agent
- #tool-calling
- #human-in-the-loop
- #fastapi