Table of Contents
PawCode의 논문 검색을 평가할 때 사용한 질문 중 하나다. 실제 사용자에게 받은 질문은 아니고, 논문 제목을 보고 모델이 만든 질문이다.
단식할 때 몸이 지방을 저장하고 쓰는 균형을 유지하는 세포 수준의 기전이나 단백질에 대해 다룬 논문이 있을까?
찾으려던 논문은 Rab30 facilitates lipid homeostasis during fasting.이었다. 질문에는 Rab30이라는 이름이 없다. 사용자가 유전자 이름을 알고 논문을 찾을 수도 있지만, 이렇게 현상만 설명하고 관련 연구를 물을 수도 있다고 생각했다.
지난 글에서 다룬 후보 검토 에이전트에는 두 종류의 요청이 들어온다. 후보표에서 고른 유전자의 문헌 근거를 확인하는 요청과, 증상이나 생물학적 현상을 설명하며 관련 논문을 찾는 요청이다. 처음에는 BM25로 검색했고, 두 번째 요청도 처리할 수 있는지 확인하면서 검색 구성을 바꿨다.
검색 대상과 초기 평가
처음 색인한 논문은 후보 판정 과정에서 인용한 2,655편이었다. 제목과 주제어, 논문 요약인 초록을 검색 대상으로 삼았다. 유전자 심볼처럼 정확한 낱말로 찾는 요청이 있었고, 아직 벡터 검색을 비교해 본 결과도 없어 BM25부터 사용했다.
평가셋 초안은 AI에게 맡겼다. 첫 설계는 EPAS1을 검색하고 EPAS1을 언급한 논문을 정답으로 두는 방식이었다. 이때 P@10은 97.7%였다. 상위 10개 결과 중 정답으로 정한 논문이 얼마나 포함됐는지를 나타내는 수치다.
유전자명을 알고 묻는 검색은 확인할 수 있었지만, 맨 앞의 질문처럼 이름을 모른 채 묻는 경우는 이 평가에 들어 있지 않았다. 그래서 논문 40편을 무작위로 고르고 제목만 모델에게 보여줬다. 그 논문을 찾고 싶은 사람이 할 법한 질문을 만들게 하되, 유전자 이름과 제목의 전문용어는 그대로 쓰지 못하게 했다.
각 질문의 정답은 질문을 만들 때 사용한 논문 한 편으로 정했다. 상위 10개 검색 결과 안에 그 논문이 있으면 성공으로 세었다. 이후 표의 Hit@10은 이렇게 성공한 질문의 비율이다. 초기 평가의 P@10과는 정답 기준과 지표가 모두 다르다.
질문을 검색어로 바꾸는 과정
평가 파일에는 같은 질문을 세 가지 형태로 저장했다. 한국어 질문, 영어 질문, 그리고 모델이 생성한 영어 검색어다. 앞서 본 Rab30 논문의 경우 다음과 같다.
한국어 질문
단식할 때 몸이 지방을 저장하고 쓰는 균형을 유지하는 세포 수준의
기전이나 단백질에 대해 다룬 논문이 있을까?

영어 질문
Are there papers about cellular mechanisms or proteins that help
maintain the balance of fat storage and breakdown during fasting?

모델이 생성한 검색어
AMPK SIRT1 ATGL fasting metabolism
당시 에이전트의 검색 경로는 사용자의 질문을 영어 키워드로 바꿔 검색 도구에 전달하는 방식이었다. 논문이 영어로 되어 있어 한국어 질문을 그대로 검색하는 경우와도 비교했다.
2,655편에서 측정한 결과는 다음과 같다. 벡터와 혼합 검색은 당시 비교한 임베딩 모델 중 각 질문 형태에서 가장 높은 값을 적었다.
| 질문 형태 | BM25 | 벡터 검색 | 혼합 검색 |
|---|---|---|---|
| 한국어 질문 | 0% | 15% | 15% |
| 영어 질문 | 82.5% | 87.5% | 87.5% |
| 모델이 생성한 영어 키워드 | 90.0% | 85.0% | 92.5% |
영어 질문에서는 벡터 검색이 87.5%였고, 모델이 만든 키워드에서는 BM25가 90.0%였다. 어떤 형태의 검색어를 전달하느냐에 따라 결과가 달랐다. 에이전트가 사용할 검색을 고르는 일이어서, 영어 질문을 그대로 넣은 결과와 도구 호출에 쓰는 검색어의 결과를 구분해서 봤다.
유전자 이름으로 찾는 요청과 현상을 설명하는 요청을 함께 다루려고 BM25와 벡터 검색을 결합했다. 두 검색의 점수를 직접 더하지 않고 검색 결과의 순위를 합치는 RRF를 사용했다.
논문 색인 확장
처음 색인은 후보 판정에서 이미 인용한 논문을 모은 것이었다. 그 밖의 문헌도 검색하려고 사람 상동 유전자 5,191개의 심볼로 확장 검색을 했다. 74,876편을 추가하면서 색인은 77,531편이 됐다.
같은 질문 40개를 다시 실행했다. 혼합 검색의 Hit@10은 92.5%에서 60.0%로 떨어졌다. 질문과 기준 논문을 그대로 두었는데도 검색 대상이 늘어나자 결과가 달라졌다.
확장된 색인에서는 임베딩 모델을 세 가지로 비교했다. 아래는 벡터 검색만의 Hit@10이다.
| 질문 형태 | MiniLM · 384차원 | text-embedding-3-small · 1,536차원 | text-embedding-3-large · 3,072차원 |
|---|---|---|---|
| 모델이 생성한 영어 키워드 | 52.5% | 55.0% | 70.0% |
| 영어 질문 | 47.5% | 52.5% | 80.0% |
| 한국어 질문 | 0% | 0% | 45.0% |
이 비교에서 text-embedding-3-large를 선택했다. 영어 질문뿐 아니라 한국어 질문에서도 기준 논문을 찾는 비율이 달라졌다. 다만 에이전트의 검색어 생성은 영어로 유지했다.
모델을 바꾸면서 문서도 다시 임베딩했다. 코드에서는 이전 MiniLM 색인인 papers_v1과 새 색인인 papers_large를 구분했고, 질문을 임베딩할 때도 문서와 같은 모델을 사용하도록 했다.
호출 시간과 저장 공간도 달라졌다. 당시 실험 기록에서 검색 왕복 시간은 310ms에서 1,020ms로 늘었고 저장량은 약 953MB였다. 문서 임베딩에 한 번 비용이 들고, 이후에도 질문을 검색할 때 임베딩 API를 호출하는 구성이 됐다.
도구 설명과 문장형 검색어
임베딩 모델을 바꾼 뒤에도 확인할 부분이 있었다. text-embedding-3-large의 벡터 검색 결과는 영어 질문에서 80.0%, 모델이 만든 키워드에서 70.0%였다. 실제 도구에 넘기는 검색어를 살펴봤다.
Rab30 논문을 찾는 질문에 생성된 검색어는 AMPK SIRT1 ATGL fasting metabolism이었다. 질문에 없던 유전자명이 들어가 있었다. 이전 도구 설명에는 유전자 이름을 알면 반드시 포함하라는 지시가 있었는데, 이 질문에는 특정 유전자명을 정할 만한 정보가 없었다.
실험 기록에서는 이 검색어로도 fasting metabolism 같은 주변 표현 덕분에 기준 논문을 찾은 사례가 남아 있다. 검색 결과만 보면 성공으로 세지만, 검색어에 붙은 유전자명까지 답변의 근거로 삼아서는 안 되는 경우였다.
lookup_papers의 query 설명을 수정했다. 유전자명을 채워 넣도록 하는 지시를 빼고, 낱말을 나열하는 대신 영어 문장으로 쓰도록 했다. 수정한 도구 설명으로 검색어를 다시 생성하자 같은 질문이 다음처럼 바뀌었다.
키워드형
AMPK SIRT1 ATGL fasting metabolism

문장형
Cellular mechanisms and proteins that regulate the balance
between lipid storage and mobilization during fasting.
문장형 검색어에는 특정 유전자명 대신 지방의 저장과 동원, 단식이라는 질문의 내용이 담겼다. 이 사례만으로 검색어 오류가 모두 없어졌다고 판단할 수는 없지만, 도구 설명을 바꾼 결과를 질문 단위로 확인할 수 있었다.
새 검색어를 평가 파일에 저장하고 같은 40문항을 다시 실행했다. 색인 77,531편과 text-embedding-3-large는 유지했다.
| 검색 방식 | 키워드형 검색어 | 문장형 검색어 |
|---|---|---|
| BM25 | 57.5% | 67.5% |
| 벡터 검색 | 70.0% | 82.5% |
| 혼합 검색 | 67.5% | 90.0% |
혼합 검색에서는 모델 교체 후 67.5%였던 값이 검색어 변경 후 90.0%가 됐다. 임베딩 모델과 도구 설명을 차례로 바꾸고, 각 단계의 검색어와 결과를 남겼다.
에이전트의 검색 경로
현재 문장 검색은 다음 순서로 동작한다.
사용자의 질문
  → 모델이 영어 문장형 검색어 생성
  → Milvus에서 BM25 검색 + 벡터 검색
  → RRF로 결과 순위 결합
  → 검색된 논문을 에이전트의 답변 근거로 전달
코드에서는 BM25와 벡터 검색에서 각각 최대 30개를 가져와 순위를 결합한다. RRF의 k는 60으로 고정했다. 평가에서는 최종 상위 10개를 확인했지만, 실제 도구의 기본 반환 편수는 5편이다. 평가의 Hit@10을 실제 답변에 포함되는 논문의 적중률로 그대로 읽을 수는 없다.
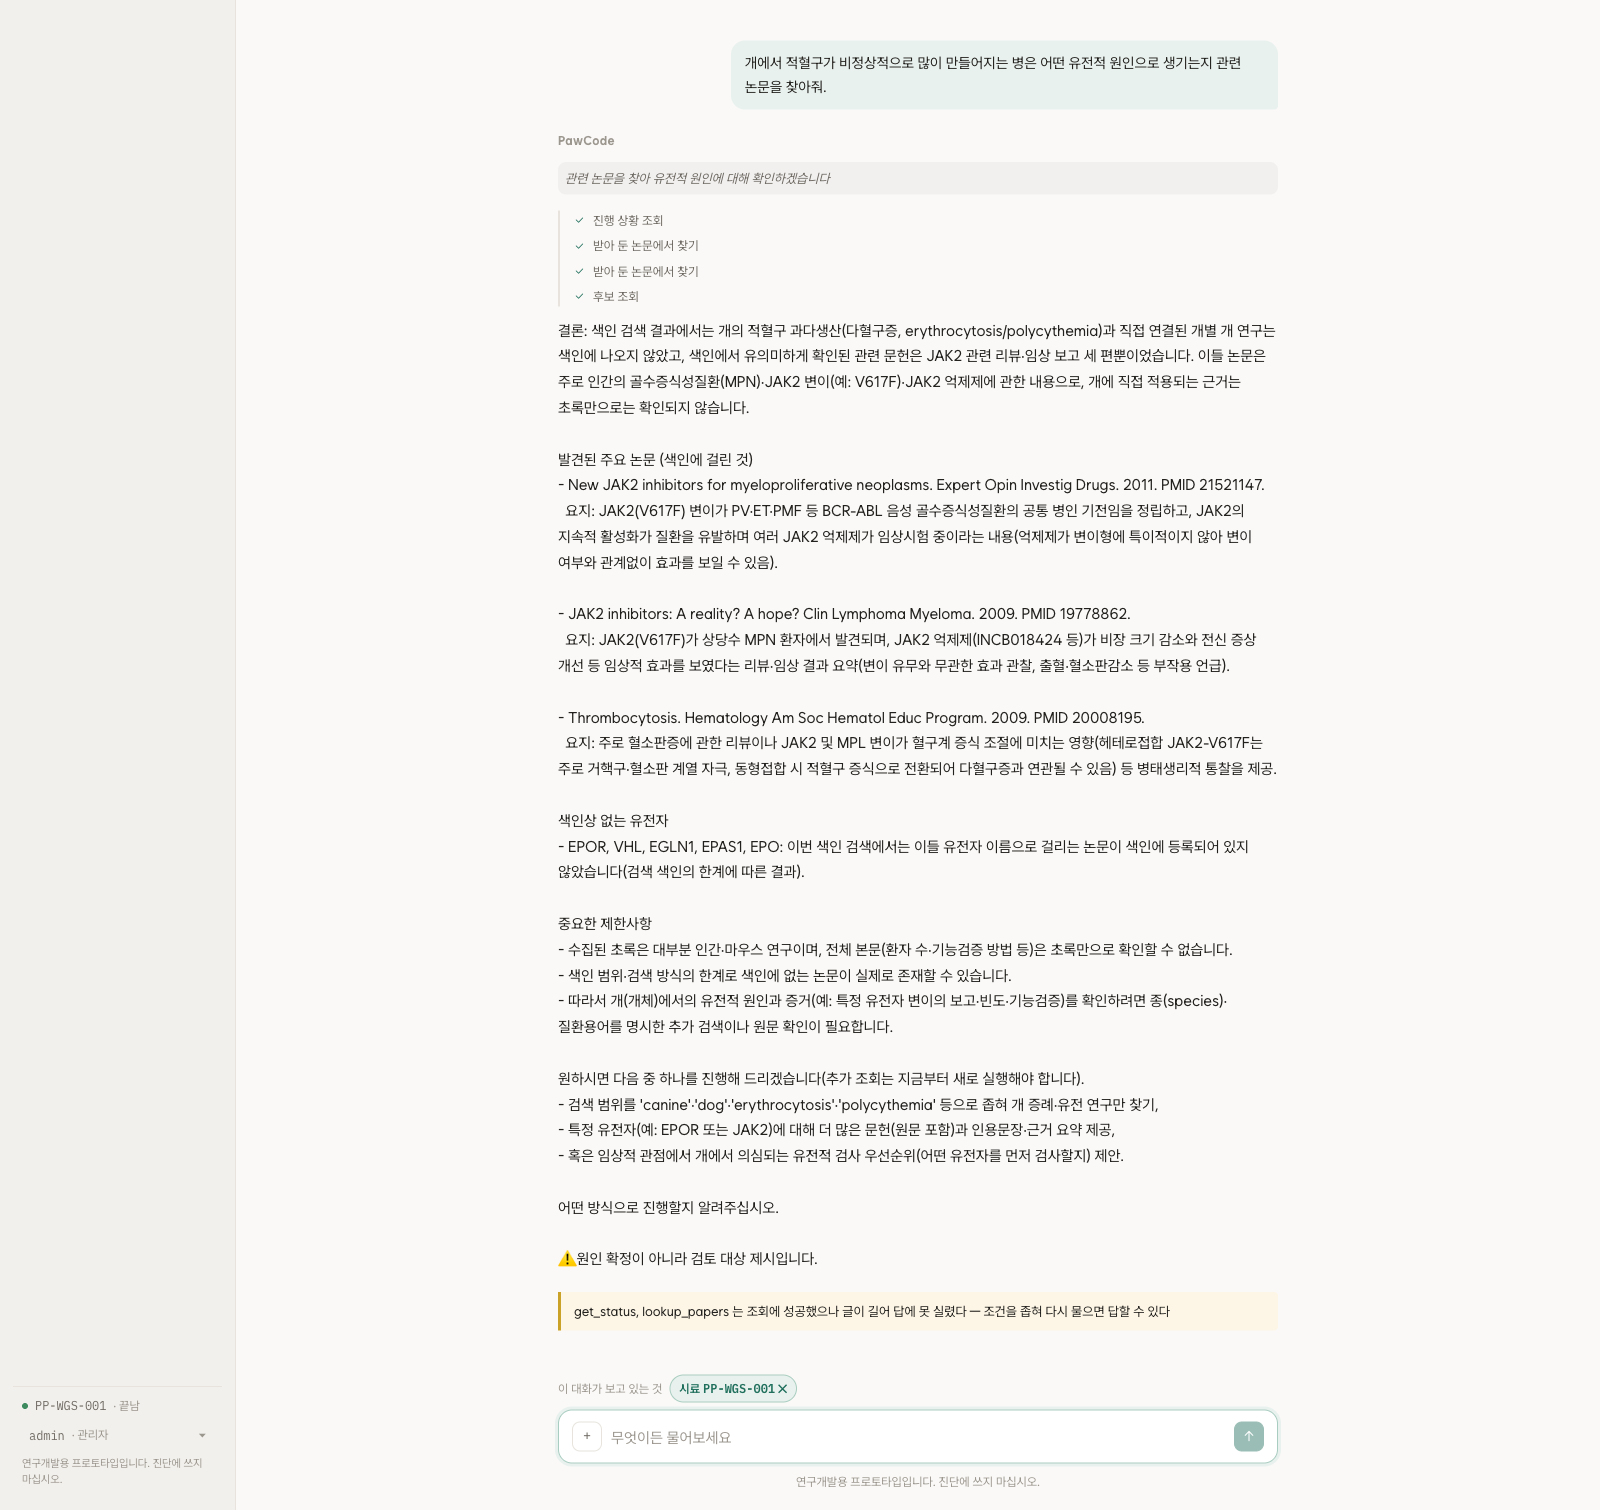
화면에서는 논문 제목과 요약, PMID를 함께 보여준다. 사용자가 에이전트의 설명을 읽다가 원문도 확인할 수 있도록 했다.
벡터 저장소는 Zilliz Cloud의 Milvus를 사용했다. WGS 파이프라인과 API를 같은 분석 서버에서 실행하고 있어서, 벡터 저장소의 CPU와 메모리 사용을 분리하려는 선택이었다. 관리형 벡터 저장소를 직접 운영해 보는 것도 프로젝트에서 해 보고 싶은 일이었다.
외부 저장소와 임베딩 API에 의존하는 만큼 실패했을 때의 경로도 필요했다. Milvus 연결이나 질문 임베딩이 실패하면 로컬 BM25로 검색하고, 도구 응답에 뜻 검색을 수행하지 못한 이유를 남긴다. 로컬 검색에서도 제목과 주제어 가중치를 사용하며 유전자 심볼이 달라지지 않도록 어간 처리는 하지 않았다.
평가 범위
이번에 확인한 90.0%는 같은 합성 질문 40개 중 36개에서 기준 논문을 상위 10개 안에 찾은 결과다. 이 질문들로 모델과 검색어 구성을 비교했으며, 별도로 분리한 평가셋의 검증 결과는 남아 있지 않다. 검색어도 파일에 저장된 것을 사용했으므로 매번 에이전트가 새로 검색어를 만들고 답변하는 전체 과정을 평가한 수치는 아니다.
질문마다 정답을 한 편만 둔 한계도 있다. 다른 관련 논문을 찾아도 기준 논문이 없으면 실패로 세고, 기준 논문을 찾아도 에이전트가 잘못 설명하는 경우는 잡아내지 못한다.
다음 평가에는 실제 사용자의 질문과 검토한 논문을 모으려고 한다. 검색 구성 비교에 사용하지 않은 질문을 따로 두고, 실제 도구가 반환하는 편수에서도 확인할 필요가 있다. 최종 답변이 논문의 내용을 정확하게 설명하는지는 그와 별도로 평가해야 한다.
PawCode 시리즈
- 53GB WGS 데이터를 처리하는 29단계 파이프라인 만들기
- 변이 후보의 근거와 검토 순위
- 대화로 다루는 유전체 분석과 변이 해석
- PawCode의 논문 검색 구성과 평가
- PawCode 에이전트의 가드레일과 실행 기록
- #pawcode
- #rag
- #bm25
- #vector-search
- #rrf
- #milvus
- #evaluation